易君召
易君召
发布于 2026-10-18 / 25 阅读
0

2026年主流运维监控工具对比选型分析

主流运维监控工具简单分类:

  • 指标监控(Metrics):主机、CPU、内存、QPS、延迟等数值时序数据

  • 日志(Logs):应用日志、系统日志

  • 链路追踪(Traces / APM):微服务调用链、服务性能

  • 一体化 SaaS 可观测:托管式,指标 / 日志 / 链路打包

现代可观测三大支柱:Metrics + Logs + Traces;OpenTelemetry 是统一采集 SDK 标准。

一、核心工具对比总表
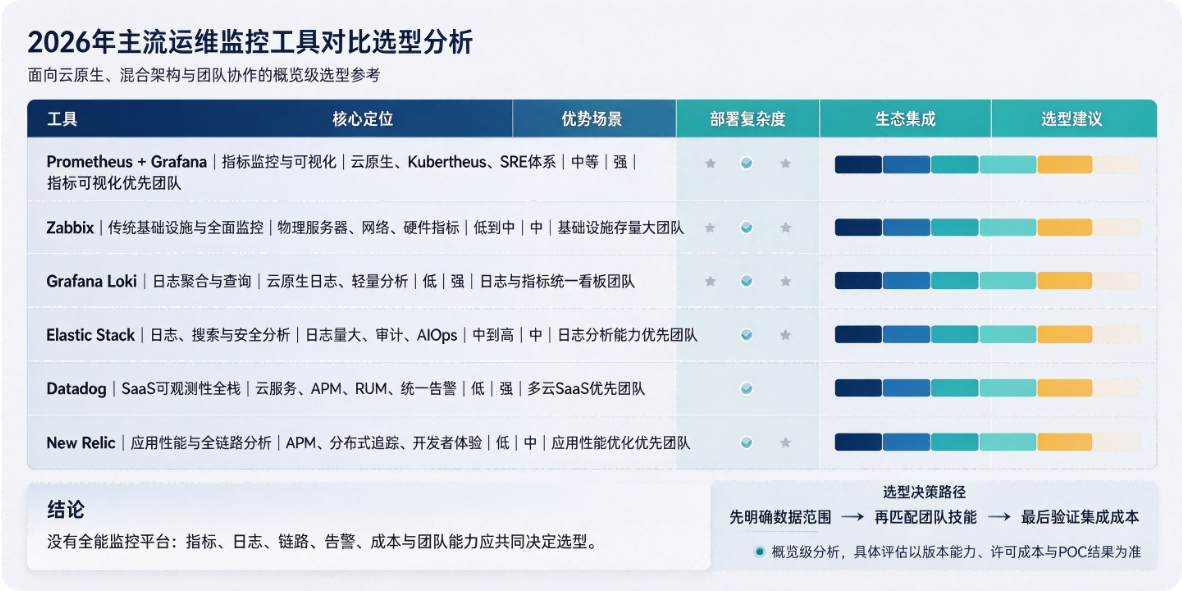
工具

类型

开源

采集模型

优点

缺点

最佳适用场景

Prometheus + Grafana

指标 + 可视化

Prometheus 开源,Grafana 开源核心

Pull 拉取

CNCF 毕业,PromQL 强大;海量 Exporter;K8s 原生适配;Grafana 多数据源看板,生态最强

Prometheus 只存指标,不支持日志 / 链路;原生存储短期,长周期要 Thanos/Cortex;大规模 HA 运维成本高

K8s、容器、微服务、云原生基础设施指标监控(目前行业标准组合)

Zabbix

基础设施全监控

开源

Agent / 无 Agent

一站式:主机、网络、数据库、SNMP;自带告警、报表、模板;传统机房能力极强

UI 老旧;MySQL 存储大数据容易瓶颈;容器动态发现弱;配置复杂,不适合大规模 K8s

传统 IDC、物理机、交换机、机房网络,政企老旧基础设施

Nagios

基础状态监控

开源

插件模型

历史悠久,插件极多;告警稳定;适合做存活检查

图形能力弱,需要额外绘图;不适合动态容器;扩展性差,维护繁琐OpenObserv...

轻量存活巡检、小机房、简单服务可用性监控,现在逐步被 Zabbix/Prom 替代

ELK Stack(Elasticsearch+Logstash+Kibana)

日志平台

开源

Push 推送

全文检索日志能力强;可扩展到 APM;日志结构化分析成熟

资源消耗巨大;运维重;成本高;新版商业协议限制;日志量大时索引压力大

海量日志检索、应用日志排查,传统日志分析场景

Loki + Grafana

轻量日志

开源

Push

轻量化,只存索引,原始日志放对象存储;和 Prometheus/Grafana 天然打通;资源占用远低于 ELK

不适合全文检索,适合日志过滤,复杂文本搜索弱

云原生环境日志,和 Prom 配套搭建轻量可观测栈

SkyWalking

APM / 链路追踪

国产开源

Agent 埋点

Java 微服务自动埋点;支持指标、日志、链路三合一;中文文档友好,国内普及高;存储可选 ES/BanyanDB/MySQL

非 Java 语言埋点能力弱;超大集群存储压力大

Java 微服务分布式追踪、应用性能监控,国内企业微服务

Jaeger

链路追踪

CNCF 开源

OTel

OpenTelemetry 原生支持;专注 Trace,轻量;多语言

只做链路,无指标日志能力,需要搭配其他工具

纯分布式调用链排查,多语言微服务

Datadog

一体化 SaaS 可观测

商业

Agent 推送

Metrics/Logs/Traces/ 安全 / 合成监控一站式;开箱即用,无需自建运维;云厂商原生集成

费用高,数据出境问题;私有化弱

海外云业务、创业团队不想维护监控组件

SigNoz

一体化开源可观测

开源

OTel

一套平台搞定指标、日志、链路;底层 ClickHouse,存储高效;原生 OpenTelemetry

部署组件多,运维复杂度高于 Prometheus;社区相对年轻

想一套系统替代 Prom+Loki+Jaeger 的团队

Netdata

实时主机监控

开源

Agent 本地采集

一键部署;实时主机看板,开箱即用;资源占用小

不擅长长期存储;告警体系弱;不适合大规模集群

单台 / 少量服务器快速排查,应急看主机实时状态

二、重点工具深度解读

1. Prometheus + Grafana(云原生首选)

Prometheus:时序指标数据库,Pull 模型,定期去目标拉取 /metrics;标签体系多维查询,PromQL 是核心;Alertmanager 负责告警分组、降噪、路由。 Grafana:可视化面板,支持 Prometheus、Loki、Zabbix、ES 等几乎所有数据源,看板模板社区极多。

短板:只负责指标。日志和链路要额外搭 Loki、Jaeger/SkyWalking。大规模长周期存储需要 Thanos 或者 VictoriaMetrics。

2. Zabbix(传统机房王者)

适合物理机、Windows 服务器、交换机、路由器 SNMP 监控。自带模板、自动发现、告警、报表。

短板:MySQL 作为底层存储,当监控对象上万后性能压力明显;Pod 动态扩缩容场景适配差。

3. ELK / Loki:日志工具对比

  • ELK:强在全文检索,适合日志模糊搜索;缺点吃资源,堆机器。

  • Loki:不索引日志正文,只索引标签,存储成本低;不适合全文检索,适合按服务 / 实例过滤日志。云原生环境一般搭配 Prometheus。

4. SkyWalking(国产 APM)

国内 Java 微服务最常用链路工具。Java 应用无侵入 agent,自动采集调用链路、JVM 指标、错误日志。

适合:SpringCloud 微服务;不适合:大量 Go/Python 应用。

三、选型建议(直接对号入座)

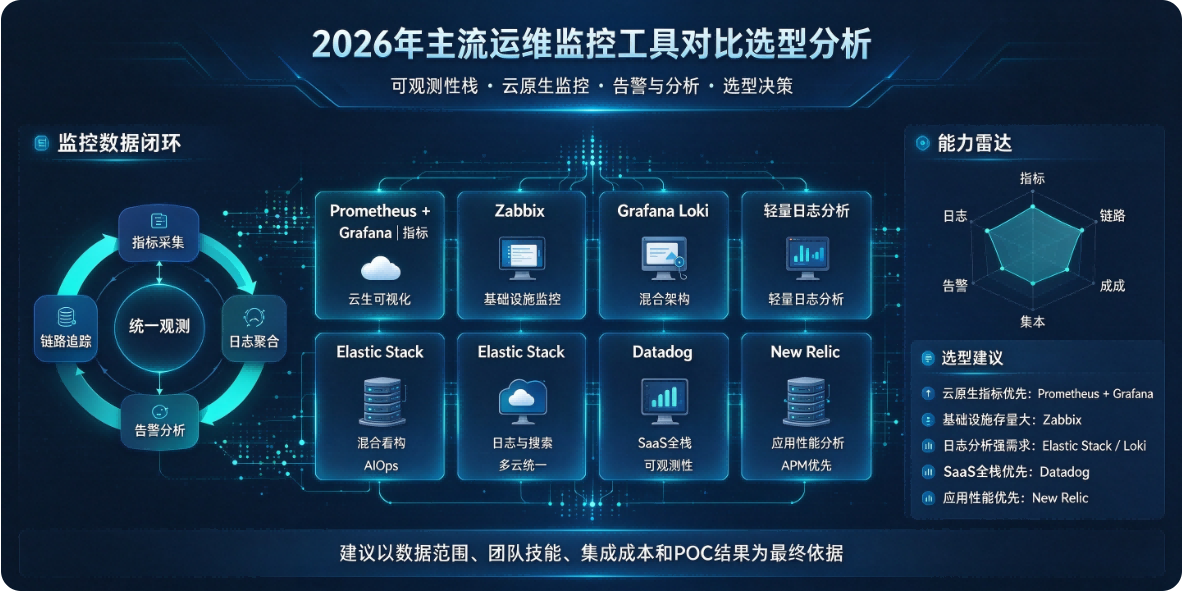
  1. K8s / 容器、微服务,云原生:推荐 Prometheus + Grafana + Loki + OpenTelemetry(链路用 SkyWalking/Jaeger)

  2. 传统机房、物理机、网络设备大量:Zabbix;如果只是简单存活检查,Nagios

  3. 海量日志,需要全文检索:ELK(Elastic Stack)

  4. Java 微服务,需要调用链排查:SkyWalking

  5. 不想自己维护一堆组件,预算充足:Datadog(国内企业注意合规)

  6. 想一套开源系统统一指标 + 日志 + 链路:SigNoz

四、常见组合方案参考

  1. 云原生标准栈:Prometheus + Grafana + Loki + Jaeger + OpenTelemetry

  2. Java 微服务栈:Prometheus + Grafana + SkyWalking

  3. 传统 IDC:Zabbix + ELK


本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。

原文链接 https://www.yijunzhao.cn/archives/2026-ops-monitoring-tools-comparison-selection-analysis

欢迎访问 小易撩挨踢

https://www.yijunzhao.cn/