
APM(Application Performance Monitoring,应用性能监控),本质是把性能观测能力嵌入到持续交付流水线,实现发布前校验、发布中灰度风控、发布后快速验证、出问题快速定位,打通 “代码提交 → 构建 → 部署 → 线上运行” 的可观测闭环,避免持续部署变成持续踩坑。
DevOps 追求快速高频发布;高频发布最大风险就是:新代码引入性能退化、接口超时、内存泄漏、依赖变慢。APM 就是这条流水线的性能质量门禁 + 线上验收工具。
一、发布前:作为准入门禁(左移,Shift Left)
很多人只把 APM 当线上工具,现代方案会把 APM 探针 / 压测采集能力放到测试环境、预发环境:
自动化回归时采集链路指标(响应时间、错误率、吞吐量、DB 慢 SQL、外部依赖耗时)
配置 SLO 阈值:比如 P95 延迟上涨超过 30%、错误率 > 0.5% 直接阻断流水线
和基线对比:拿本次构建的性能指标,和上一个稳定版本基线对比,识别隐性性能退化(比如慢 SQL、N+1、锁竞争)
价值:不让带性能问题的包流入下一环境,提前拦截,而不是发到生产才发现。
二、发布过程中:灰度 / 滚动发布的实时风控(最核心价值)
持续部署常用金丝雀、蓝绿、滚动发布:
流量切一部分到新版本,APM 实时对比新旧版本指标(错误率、耗时、JVM GC、数据库、Redis、第三方调用)
配置自动化告警 + 流水线回调:一旦新版本指标破阈值,自动触发回滚
分布式链路追踪:同一个 traceId 看新旧实例的调用差异,快速区分是新版本代码问题,还是下游依赖抖动
价值:高频发布下,不用人工盯屏,由数据决定要不要继续放量,是安全灰度的基础。
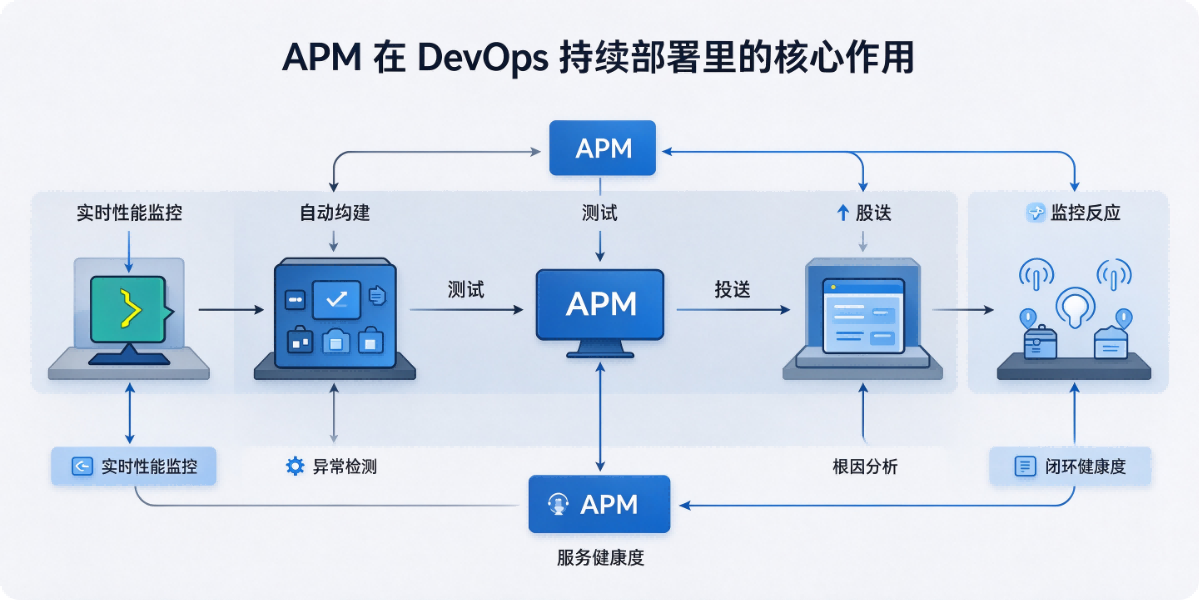
三、发布后:发布效果验收 + 根因定位
发布变更关联:APM 和 CICD 平台打通,每条指标曲线打上版本号、commit、部署批次标签,一眼看到 “是不是这次发布导致的抖动”
端到端链路:从前端请求 → 网关 → 微服务 → DB / 缓存 / MQ,定位是代码逻辑、SQL、外部依赖、资源瓶颈哪一层变差
业务指标联动:接口性能 + 下单、支付等业务指标一起看,区分 “技术慢” 还是业务流量上涨
价值:验证本次发布是否符合预期;故障时缩短 MTTR(平均恢复时间),符合 DevOps 快速恢复理念。
四、长期:反哺开发、优化迭代(持续改进闭环)
收集生产真实流量下的性能画像,给开发提供真实场景的优化依据,而不是只靠本地压测
沉淀版本性能基线,形成长期质量看板,识别趋势:比如每次迭代 P95 延迟缓慢上涨,提前优化
识别薄弱依赖:某个第三方接口、慢 SQL 每次发布都容易出问题,推动重构、加缓存、限流降级
五、和 DevOps 其他模块的简单分工对比
CI:单元测试、代码扫描、构建制品(功能、安全)
自动化测试:功能、接口、压测(模拟流量)
APM:真实流量下的性能、错误、链路观测(真实流量)
日志:文本明细;监控指标:时序指标;APM = 指标 + 链路追踪 + 火焰图 + 服务拓扑,是更高阶的可观测
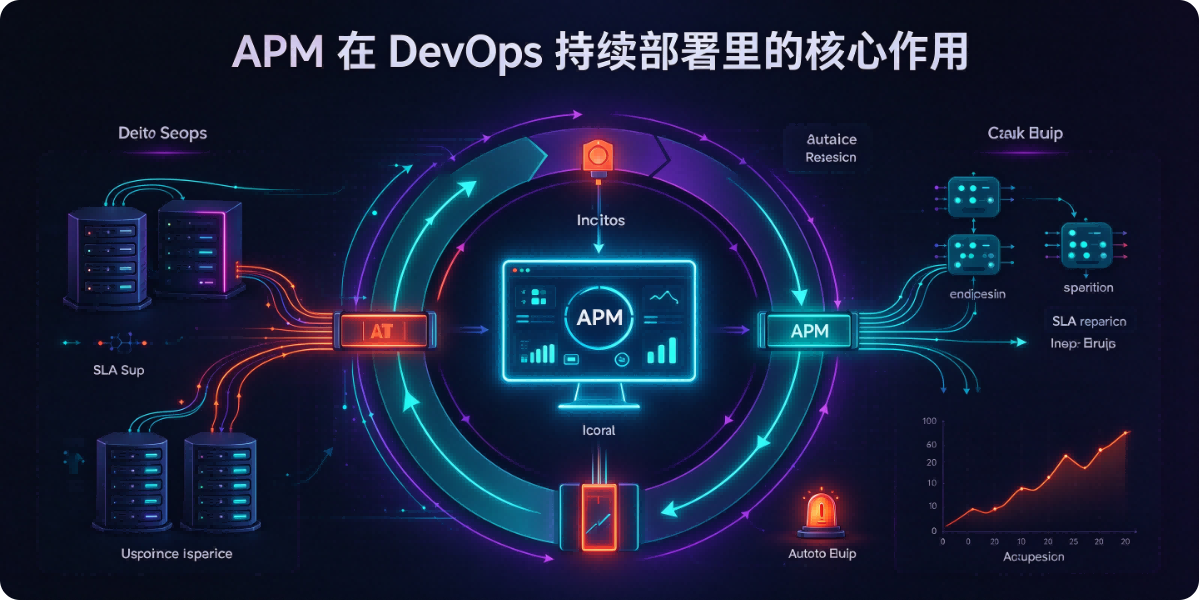
六、典型落地流程示例
代码提交 → CI构建 → 自动化测试(APM采集预发指标,基线校验不通过阻断)
→ 预发验证通过 → 触发金丝雀发布(切5%流量到新版本)
→ APM持续对比新旧版本SLO
    ✅ 指标正常 → 自动放量,全量发布
    ❌ 指标异常 → 自动停止放量 + 触发回滚 + 推送告警+链路快照给研发
→ 发布完成后,APM标记本次变更,持续观测,形成版本性能记录
七、一句话总结
APM 给持续部署补上性能质量的可量化验收标准和自动化熔断能力,让 DevOps “快速发布” 的同时可控、可回滚、可定位,而不是盲目上线。
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢