
整体思路:夯实计算机基础 → 掌握大数据核心组件 → 实战项目 → 方向细分(开发 / 数仓 / 数据分析)
阶段 1:前置基础(1~2 个月,重中之重)
大数据不是孤立技术,底层是 Linux、数据库、编程基础,新手跳过这一步极易卡在组件部署。
Linux:优先学 CentOS/openEuler 常用命令,用户权限、进程、网络、shell 脚本,大数据所有框架都跑在 Linux 上。
编程语言
首选:Java(大数据底层 Hadoop、Spark 原生语言,推荐 Java8/17,基础语法、面向对象、集合)
备选:Python(侧重数据分析、数据采集,上手更快)
数据库 & SQL:MySQL 为主,吃透 SQL 查询、关联、索引;理解表、分区、事务,数仓的基础就是 SQL。
阶段 2:大数据核心生态(2~3 个月)
按数据流顺序学习,理解数据采集→存储→计算→调度整条链路
分布式存储:Hadoop HDFS 分布式文件系统、MapReduce 计算模型、YARN 资源调度,大数据基石,一定要动手搭单机 / 伪分布式环境。
数据仓库:Hive 把 SQL 翻译成 MapReduce/Spark,离线数仓核心,学习建表、分区、分桶、数据导入、ETL。
分布式计算:Spark 主流计算引擎,分为 Spark Core、Spark SQL,离线计算;后续再学 Spark Streaming 流处理。
消息队列:Kafka 实时数据流枢纽,理解生产者、消费者、分区,用于实时数据采集削峰。
调度工具:Airflow/Azkaban 定时调度离线任务,搭建任务工作流。
新手建议:先吃透 Hadoop+Hive+Spark,不要一次性堆太多组件。
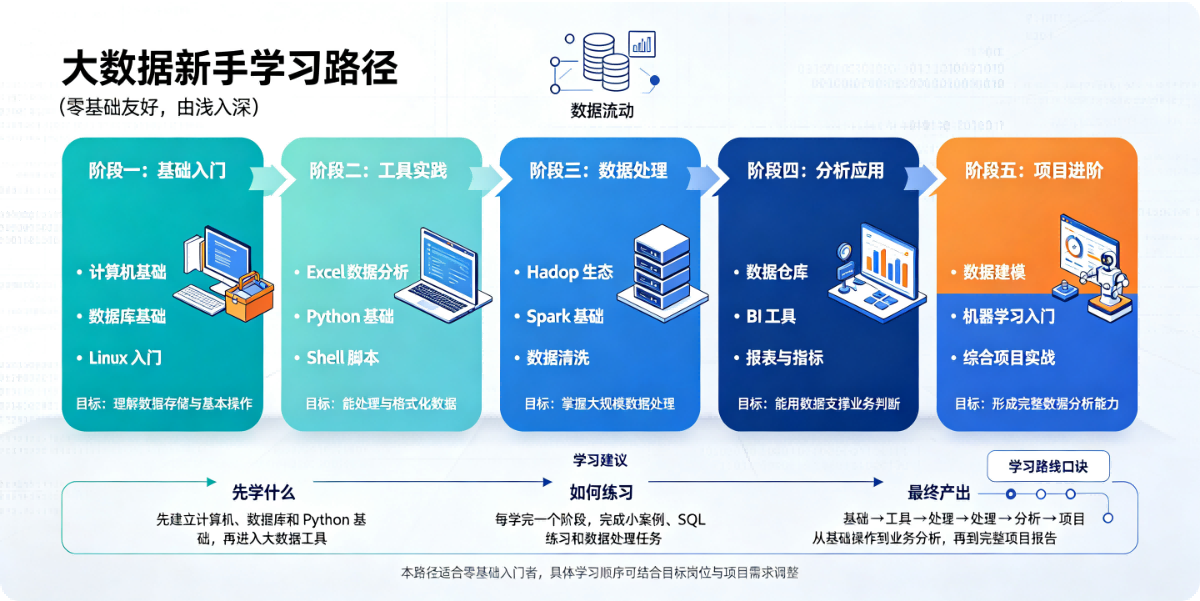
阶段 3:实战项目(1~2 个月,找工作核心)
不要只看视频,必须动手,推荐 2 个入门项目:
离线数仓项目:模拟网站用户行为日志,采集→HDFS 存储→Hive 分层建模(ODS/DWD/DWS/ADS)→统计报表。
实时数据项目:日志接入 Kafka,Spark Streaming/Flink 实时清洗,写入 MySQL。
Flink 可以放在 Spark 之后学习,实时计算现在岗位需求很高。
阶段 4:方向选择 & 进阶
大数据开发工程师:深耕 Java/Scala,Spark、Flink 调优,集群运维,源码阅读。
数据仓库工程师:维度建模、数据分层、指标体系、数据质量,重点 Hive、SQL。
大数据分析师:侧重 Python、SQL、可视化(Superset),弱化底层集群开发。
新手避坑提醒
不要一上来啃源码,先理解组件作用和数据流;
不要只看视频不搭环境,报错排错才是成长最快的方式;
优先学习稳定版本,不要追最新预览版;
理论 + 项目并行,空学理论很容易遗忘。
配套学习资源推荐
文档:Apache 官方文档(最权威)
课程:尚硅谷、黑马大数据入门视频(适合新手)
书籍:《Hadoop 权威指南》《Spark 快速大数据分析》《数据仓库工具箱》
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢