
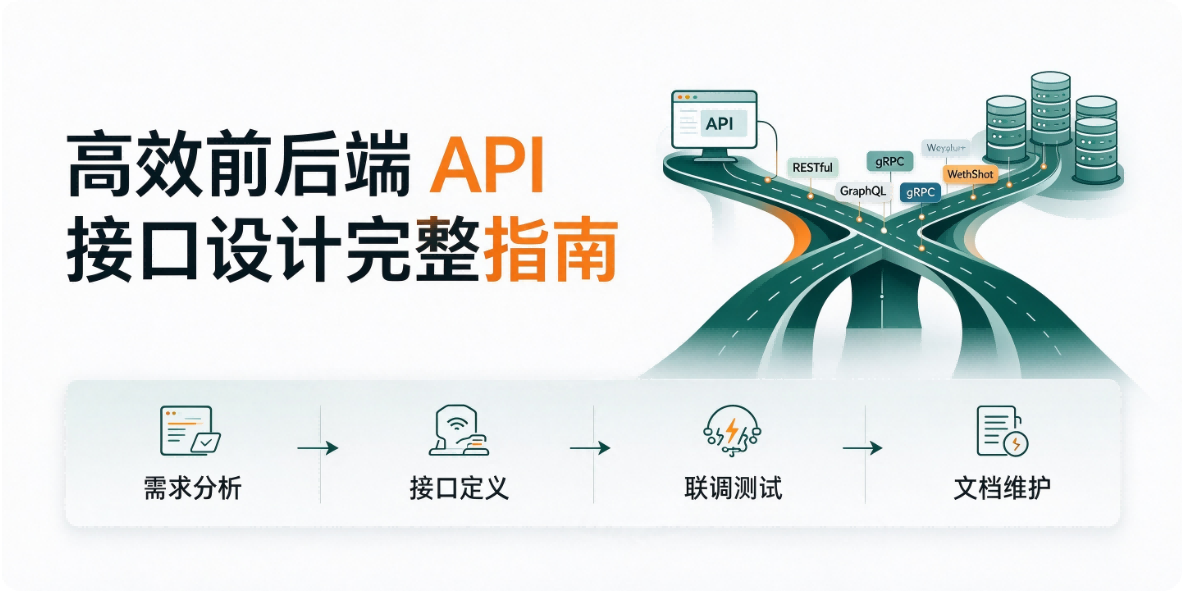
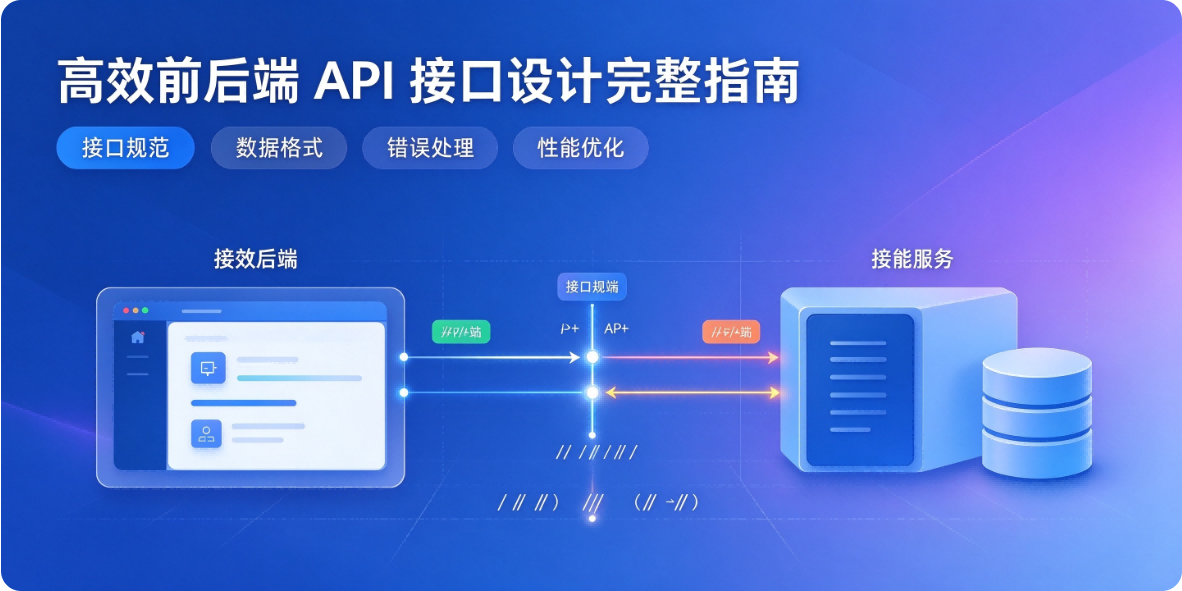
核心目标:降低联调成本、减少网络开销、便于版本迭代、易于排查问题、保障安全,下面从规范、数据结构、性能、错误处理、版本、安全、工程实践完整梳理,适合团队落地。
一、接口风格选型
RESTful(最通用,CRUD 场景)
资源用名词复数,不要动词 ✅
GET /users获取用户列表 ✅GET /users/{id}获取单个用户 ✅POST /users创建用户 ✅PUT /users/{id}全量更新用户 ✅PATCH /users/{id}局部更新(推荐优先用 PATCH) ✅DELETE /users/{id}删除用户HTTP 方法语义严格区分:
GET:只读,不能修改数据、可缓存
POST:新增 / 复杂操作,非幂等
PUT:全量替换,幂等
PATCH:部分字段更新,幂等
DELETE:删除,幂等
注意:REST 不是银弹。复杂业务动作(导出、审批、工作流)不要硬套资源,可以用 POST
/orders/{id}/approve子资源形式,或者考虑 RPC 风格。
RPC 风格(高频内部服务、复杂业务)
适合微服务内部、复杂事务、批量操作,比如 gRPC。
优点:强类型、序列化更快、自动生成 SDK;
缺点:浏览器无法直接调用,对外暴露一般需要网关转 HTTP。
对外给前端的接口,优先 HTTP+JSON REST;服务间通信可 gRPC。
二、URL 命名规范
全部小写,横线
-分隔,禁止驼峰、下划线 ✅/user-address❌/userAddress//user_address层级不要太深,建议最多 2~3 层:
/org/{orgId}/users不要在 URL 放业务描述动词,资源优先
过滤、分页、排序全部放在 query 参数,不要写进路径
GET /users?page=1&size=10&status=active&sort=createTime,desc
三、请求设计
1. 请求参数位置选择
表格
2. 分页设计(必做,防止大数据量 OOM)
标准参数:
page:页码,从 1 开始(前端习惯)size:每页条数,限制最大值,比如最大 200,防止恶意拉取total:总条数totalPages:总页数
优化:大数据场景不返回 total,使用游标分页
cursor=xxx,避免 count (*) 性能灾难
{
  "code": 0,
  "msg": "success",
  "data": {
    "records": [],
    "page": 1,
    "size": 10,
    "total": 100
  }
}
3. 筛选、排序
多条件:
?status=1&type=2多值:
?ids=1,2,3或者?ids=1&ids=2(框架支持数组)排序:
?sort=createTime,desc,支持多字段sort=createTime,desc&sort=name,asc
4. 字段按需返回(提升性能)
字段裁剪,非常关键,避免返回大对象、冗余字段。 方案:增加 fields 参数 GET /users?fields=id,name,phone 后端只返回指定字段,减少 JSON 体积。
四、统一返回体设计(前后端联调最大痛点)
推荐全局统一结构,不要每个接口返回格式不一样。
{
  "code": 0,          // 业务码:0成功;非0业务异常
  "msg": "success",   // 人类可读提示
  "data": {},         // 业务数据,成功时有效;失败可以为null
  "traceId": "xxxx"   // 链路追踪ID,排查日志必备
}
❌ 不要混用 HTTP 状态码表达业务错误! HTTP 状态码表达传输层面:
200 OK:http 请求成功(业务成功 / 业务错误都返回 200)
400:参数错误
401:未登录 /token 失效
403:权限拒绝
404:资源不存在
429:限流
500:服务内部异常
业务错误由 code 区分,例如:
10001:账号不存在
10002:密码错误
两种流派: 流派 A(推荐前端):全部返回 200,靠 code 判断业务结果,前端拦截逻辑简单; 流派 B:严格 HTTP status。对外 API 常用 B,内部后台项目 A 更省心。
列表 vs 单条
查询列表:
data是对象,里面包含 records 数组 + 分页信息(上面示例)查询单条:
data直接是实体对象无返回(如删除):
data=null
五、错误处理规范
错误信息区分两类:
给用户看:msg,简洁友好,不要暴露堆栈、SQL
给开发看:traceId,后端日志里存详细异常栈,前端根据 traceId 反馈问题
参数校验:批量返回所有校验错误,不要一次只返回一个字段
{
  "code": 40001,
  "msg": "参数校验失败",
  "data": [
    {"field":"name","message":"姓名不能为空"},
    {"field":"phone","message":"手机号格式错误"}
  ],
  "traceId":"xxx"
}
六、版本控制(API 演进,避免改接口炸前端)
方案优先级:
Header 版本(推荐):
Accept: application/vnd.xxx.v1+json,URL 干净路径版本:
/api/v1/users,简单直观,中小项目首选Query 参数版本:
/users?version=v1(不推荐,容易和业务参数混淆)
原则:接口一旦发布,不要破坏性修改。新增字段兼容旧版本;修改 / 删除字段必须升级版本。
七、性能优化(高效核心)
减少请求次数
批量接口:不要循环调用单条查询,提供
/users/batch聚合接口:前端页面需要多个数据,后端聚合接口,减少前端多次请求(BFF 层思想)
压缩传输:开启 Gzip / Brotli,JSON 体积下降 50%+
缓存策略
GET 接口合理设置
Cache-Control、ETag,浏览器缓存热点数据后端 Redis 缓存
大文件 / 大数据导出
不要同步返回超大文件:异步任务 + 任务接口,完成后返回下载链接
流式响应:
application/octet-stream,分片输出,避免服务内存溢出
超时、限流
网关层限流:IP / 账号维度
429 Too Many Requests设置接口超时时间,防止慢查询拖垮服务
八、安全设计
认证:JWT / OAuth2,token 放 Header
Authorization: Bearer xxx,不要放 URL 参数(日志会打印泄露)权限:接口级别 + 数据级别权限校验,禁止越权查询(比如只能看自己的数据)
输入校验:所有前端传入参数校验,防 SQL 注入、XSS;
敏感数据:手机号、身份证脱敏返回;传输全程 HTTPS;
CSRF:表单类接口增加 csrf token;
防重提交:新增 / 提交接口加幂等号(idempotent-key),放在 Header,防止重复提交。
九、文档 & 可观测性
文档:OpenAPI 3(Swagger)自动生成,代码注解驱动,保持和代码同步;
强制字段说明、示例、枚举值;
埋点:
traceId 贯穿全链路(网关→后端→数据库)
记录接口耗时、请求量、错误率
日志:禁止打印完整请求体(敏感信息),记录 traceId、耗时、入参摘要。
十、枚举、时间、特殊类型约定
时间:统一 UTC 时间戳(毫秒)
1728864000000,或者 ISO86012026-10-17T10:00:00Z;禁止返回本地时间字符串,时区混乱大坑;布尔:
true/false,不要用 0/1 混用;枚举:后端返回数字编码 + 文字描述,方便前端展示
{"status":1,"statusText":"启用"}
十一、接口设计避坑清单
✅ 不要返回数据库实体直接给前端(多冗余字段、泄露内部结构),用 DTO 隔离 ✅ 不要在接口里做事务性长耗时操作 ✅ 大列表强制分页,禁止全量返回 ✅ GET 请求不做写操作 ✅ 对外接口禁用数据库字段直接映射 ✅ 字段新增必须向下兼容,不能删除旧字段、不能修改字段类型 ✅ 空数组返回 [],不要返回 null,前端减少判空报错
十二、架构分层建议
前端 <-> API 网关(鉴权、限流、日志、路由、版本) <-> BFF(可选,页面聚合接口) <-> 后端服务 <-> DB
BFF:适合多端(H5 / 小程序 / App),后端微服务很碎时,聚合数据,简化前端;
简单项目不需要 BFF,前后端直连。
最简落地模板(团队可以直接拿来当规范)
前缀:
/api/v1/REST 资源命名,GET 只读,POST 新增
统一返回体:
code, msg, data, traceId分页:page/size;大数据游标分页
时间:ISO8601 或毫秒时间戳
文档:OpenAPI3
链路:全链路 traceId
HTTPS,token 在 Authorization header