
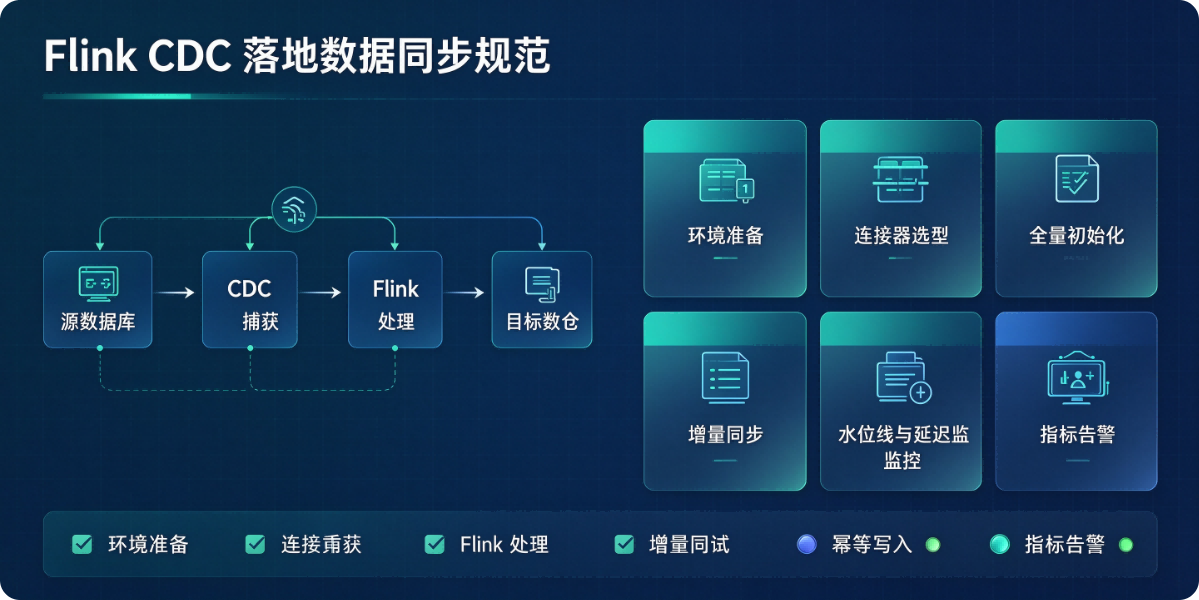
定位:统一团队 Flink CDC 同步实施标准,覆盖源端、CDC 采集、Flink 任务、目标端、异常、监控、运维、变更、权限,适用于 MySQL、PostgreSQL、Oracle 等主流库同步到 Doris、Hive、Kafka、MySQL、StarRocks 等场景;区分全量同步、增量 binlog 同步、全量 + 增量一体化(CDC 默认模式)。 适用对象:实时数仓、数据中台、可信数据空间、业务异构系统数据流转。
一、术语定义
全量快照:Flink CDC 启动时读取源表存量数据,一次性拉取
增量 binlog:快照完成后,消费数据库 binlog/redo log,同步增删改
单表任务:一个 Flink Job 只同步一张源表(推荐生产)
多表任务:单 Job 同步多张同库表,资源隔离弱,仅低优先级流水表使用
断点续传(checkpoint):任务异常重启,从最近 checkpoint 位置恢复,不丢数据、不重复(前提:幂等写入)
Schema 变更(DDL):源表加字段、改字段类型、删字段、改主键等
水位线(Watermark):用于乱序数据对齐、迟到数据处理
二、前置准入规范(上线前必须评审)
2.1 源端数据库准入
✅ 必须满足
MySQL:开启 binlog,格式 ROW,禁止 STATEMENT/MIXED;binlog_row_image=FULL(推荐,拿到完整前后镜像)
源库账号权限:
REPLICATION SLAVE, REPLICATION CLIENT, SELECT,禁止 root 账号直接给 CDC 任务主键约束:优先有主键;无主键表只能快照 + 增量,无法做 Changelog 合并、去重,风险高,需要专项审批
大表判定:单表行数 > 5000 万 标记为大表,单独资源、错峰快照(凌晨低峰启动快照)
禁止同步:核心配置表、密码 / 密钥敏感字段、大 blob/text(单独剥离或过滤)
❌ 禁止场景
源库 binlog 不持久化、binlog 过期时间过短(建议至少保留 24h,故障恢复窗口)
主从切换未配置 GTID(MySQL 推荐开启 GTID,避免位点漂移)
源库读写压力很高,无流量评估直接上 CDC
2.2 表结构与数据模型规范
主键统一:源表主键 = 目标端主键 / 唯一键,作为 upsert 的 key
字段命名:源端、目标端字段名统一小写,下划线命名;禁止特殊字符
时间字段:每张同步表必须携带业务时间(create_time/update_time),用于回溯、数据校验
敏感字段:手机号、身份证、银行卡,同步前做脱敏(CDC 侧 filter + 脱敏 UDF)
字段兼容原则:源新增字段,目标端预留兼容;源删除字段,目标端保留(保留历史数据,不删列)
DDL 策略选型(三选一,方案写在方案文档)
方案 A(保守,数仓常用):忽略 DDL,源 DDL 变更人工审批、手动修改目标表,重启 CDC 任务
方案 B(自动同步):Flink CDC 开启
schema.change.enabled=true,自动同步 DDL;适合 Kafka 下游,不适合 Doris/StarRocks(OLAP 对 DDL 敏感)方案 C:拦截 DDL,告警,不自动执行,人工介入(金融、政务强合规首选)
三、任务开发规范
3.1 任务拆分原则(强推)
大表独立 Job:单表 > 2000 万单独任务,不与其他表混跑,避免快照阶段抢占资源、拖垮其他任务
同库小表可合并:同一实例、同业务域、低 QPS 小表,最多 5 张表一个 Job;高 QPS 表禁止合并
业务隔离:不同业务域 CDC 任务,分开 Flink slot、分开 checkpoint 存储路径
3.2 Flink CDC 参数标准(MySQL 示例,基准模板)
# 基础
hostname: xxx
port: 3306
username: cdc_user
password: xxx
database-name: biz_db
table-name: biz_db.order_info
# 快照控制
scan.startup.mode: initial  # initial(全量+增量) / latest-offset(只消费增量) / specific-offset(指定位点)
scan.snapshot.fetch.size: 10240
scan.snapshot.split.size: 8096
# binlog
server-time-zone: Asia/Shanghai
# 重要:开启GTID
gtid.enabled: true
# DDL控制(政务项目一般关闭自动DDL)
schema.change.enabled: false
startup.mode 使用规范:
新表首次同步:
initial(快照 + 增量)存量已经对齐,只追实时:
latest-offset故障回溯、定点回放:
specific-offset,记录 GTID 位点归档
3.3 Flink 核心参数规范
Checkpoint
周期:30s ~ 60s;高吞吐低延迟 30s,低流量表 60s
checkpoint 存储:HDFS / 对象存储,每个任务独立目录
checkpoint 超时:checkpoint.timeout=10min
最大并发 checkpoint:1
外部化 checkpoint:
externalized-checkpoint-retention: RETAIN_ON_CANCELLATION,手动停止任务保留 checkpoint,可恢复
State
状态后端:推荐
HashMapStateBackend(小状态) /RocksDBStateBackend(大表、长链路,开启增量 checkpoint)RocksDB:开启增量 checkpoint,state 压缩,rocksdb 压缩算法 lz4
并行度
快照阶段:并行度 = 表分片数;增量阶段并行度可和快照一致,或者按需下调
禁止并行度随意放大超过源库读能力
重试策略
固定延迟重试,重试次数上限,超过直接失败告警,不无限重试打崩源库
3.4 代码 & SQL 规范(优先使用 Flink SQL 开发,可维护)
所有 CDC 任务必须写Flink SQL,尽量少用 DataStream 原生编码(便于运维、平台托管)
链路固定:
CDC Source → Filter/Map/脱敏 → 可选Flink聚合 → Sink必须显式定义:主键、元数据列(
__cdc_ts、__op_type、__database_name、__table_name)op_type:c (insert)、u (update)、d (delete),下游根据 op 做 upsert/delete
禁止在 CDC 链路写重计算、多表 join 大状态逻辑;CDC 定位是流转同步,不是复杂计算,复杂逻辑下沉到下游 OLAP
示例标准 SQL 模板:
CREATE TABLE mysql_order_cdc (
  id BIGINT PRIMARY KEY NOT ENFORCED,
  order_no STRING,
  amount DECIMAL(18,2),
  update_time TIMESTAMP(3),
  -- CDC元数据
  __op_type STRING,
  __cdc_ts TIMESTAMP(3)
) WITH (
  'connector' = 'mysql-cdc',
  'hostname' = 'xxx',
  'port' = '3306',
  'username' = 'cdc',
  'password' = 'xxx',
  'database-name' = 'biz',
  'table-name' = 'biz.order',
  'scan.startup.mode' = 'initial',
  'server-time-zone' = 'Asia/Shanghai',
  'schema.change.enabled' = 'false'
);

CREATE TABLE doris_order_sink (
  id BIGINT,
  order_no STRING,
  amount DECIMAL(18,2),
  update_time TIMESTAMP(3),
  PRIMARY KEY (id) NOT ENFORCED
) WITH (
  'connector' = 'doris',
  'fenodes' = 'xxx:8030',
  'table.identifier' = 'dw.dwd_order',
  'username' = 'doris',
  'password' = 'xxx',
  'sink.properties.format' = 'json',
  'sink.enable-2pc' = 'true' -- 两阶段提交,保证精确一次
);

INSERT INTO doris_order_sink
SELECT id, order_no, amount, update_time
FROM mysql_order_cdc;
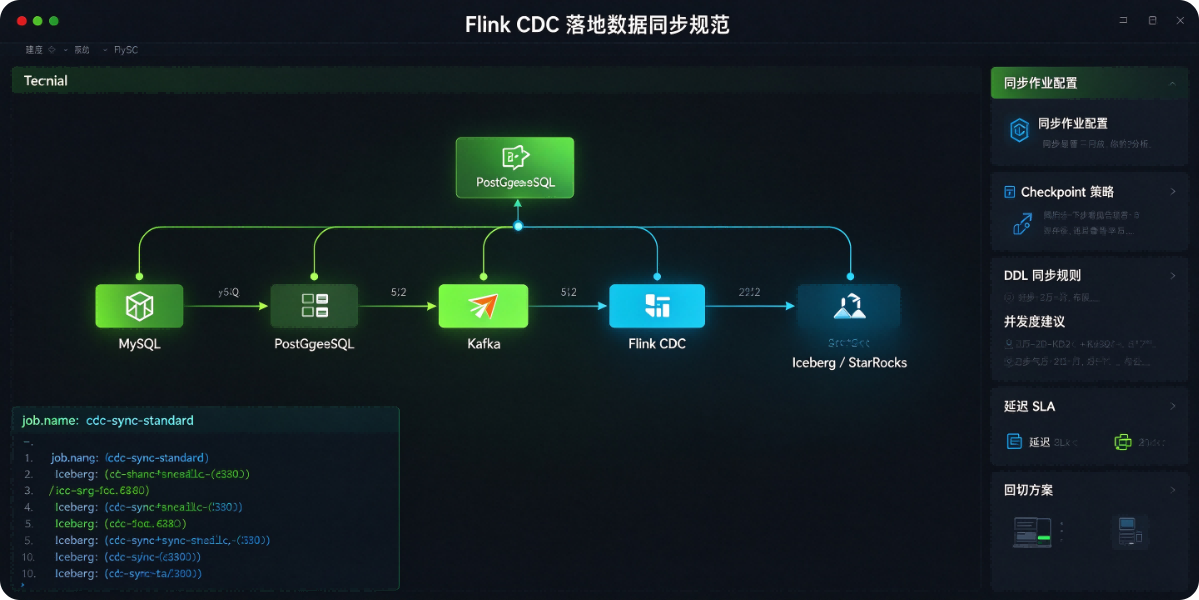
四、Sink 写入与一致性规范(核心:语义保障)
Flink CDC 默认目标:端到端 Exactly-Once(精确一次),依赖 checkpoint+sink 两阶段提交
Doris / StarRocks Sink:开启
sink.enable-2pc=true,upsert 表,主键去重Kafka Sink:写入 changelog json,带 op_type,下游消费方自己处理增删改;Kafka 无法天然 delete,适合作为 CDC 中间流转层
MySQL Sink:使用 jdbc+upsert,或者
mysql-xconnector;注意目标库不要开高频率同步回环Hive:只适合 append-only,删除、更新无法直接处理,需要拉链表方案
❌ 禁止:无主键目标表、关闭 2PC、关闭 checkpoint,对外宣称精确一次
语义分级,文档必须标注:
L1:Exactly-Once(金融、交易、账单,强制 2PC+checkpoint)
L2:At-Least-Once(日志、埋点,允许少量重复,下游幂等)
L3:BestEffort(非核心统计数据)
五、数据校验规范(上线必须做,日常定期巡检)
5.1 校验阶段
快照完成校验:快照结束后自动触发
行数校验:源表 count ≈ 目标表 count(允许微小时间差)
主键抽样校验:随机 N 条主键,比对全字段 MD5
增量实时校验(持续)
增量延迟:监控消费延迟(binlog 位点时间与当前时间差)
变更对账:按窗口(5min/1h)统计源端 C/U/D 数量 和 sink 写入数量
T+1 全量对账:每日凌晨跑对账任务,输出差异报表
5.2 差异处理规范
差异发现 → 先冻结任务(不继续追增量)→ 定位原因(过滤规则、DDL、丢 binlog、sink 失败)→ 修复后:
少量差异:单条补数
大量差异:清空目标表,重新 initial 快照同步(走变更审批)
六、监控 & 告警规范(必配指标)
每个 CDC 任务,监控看板至少包含:
消费延迟(binlog lag,核心告警指标)
阈值:>30s 预警;>5min 紧急告警
快照进度(快照阶段单独监控分片进度、快照剩余时间)
输入 TPS、输出 TPS
Checkpoint 成功率、checkpoint 时长、checkpoint 失败次数
Sink 失败数、重试次数
异常:DDL 捕获、脏数据(脏数据侧写死信 Kafka,不直接丢弃)
脏数据规范:字段类型不匹配、空主键、编码异常,进入死信 topic,输出告警,禁止直接过滤丢弃。
七、运维与变更规范
7.1 上线流程
需求评审 → 方案文档(同步范围、语义、DDL 策略、资源评估、校验规则)→ 测试环境验证(快照 + 增量 + 故障重启 + 对账)→ 预发布验证 → 生产上线 → 上线后 1h 盯屏
7.2 变更流程
源表 DDL、过滤条件、脱敏规则、并行度、启动位点变更:
提交变更单
评估是否需要重新快照(很多 DDL 变更会导致状态不兼容,需要重新 initial)
选择窗口执行,记录变更前 GTID 位点,归档
变更后对账
7.3 任务启停规范
正常下线:
cancel-with-savepoint,保存 savepoint,归档路径故障重启:优先从 checkpoint/savepoint 恢复,不随便重置位点
严禁:直接 kill taskmanager、删除 checkpoint 目录、随意切 latest-offset 不做对账
7.4 资源规范
快照阶段:内存更高,防止 OOM(分片读取大量数据)
增量阶段:CPU 看 TPS,内存看状态大小
资源隔离:生产 CDC 集群和离线计算集群分开;核心交易 CDC 独占 slot 池
八、安全规范
数据库账号最小权限原则,密码平台托管,禁止硬编码写 SQL、代码
传输链路:内网;跨网同步开启加密
敏感字段脱敏:在 Flink 算子层脱敏,不允许明文落地 Kafka/OLAP
审计:所有 CDC 任务启停、位点变更、DDL 拦截、脏数据都留审计日志,保存≥180 天(政务等合规场景)
九、常见风险红线(禁止行为清单)
不评估源库压力,高峰期启动大表 initial 快照
无主键表直接上生产,不做专项审批
关闭 checkpoint、关闭 2PC,宣称精确一次
自动 DDL 同步开启在 Doris/StarRocks 等 OLAP,DDL 乱同步导致表结构崩坏
不做对账,只看任务 running 就认为同步正常
多个高吞吐交易表合并在同一个 Flink Job,单点故障影响全部
binlog 保留时间小于故障恢复窗口
十、交付物清单(一个 CDC 同步需求必须产出)
Flink CDC 同步方案文档(本规范作为基准)
Flink SQL 脚本 + 参数配置清单
源目标字段映射表、脱敏规则、过滤规则
监控大盘配置、告警阈值
对账脚本(实时对账 + T+1 全量对账)
回滚方案、故障处理 SOP
位点归档目录、savepoint 存储路径
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢