
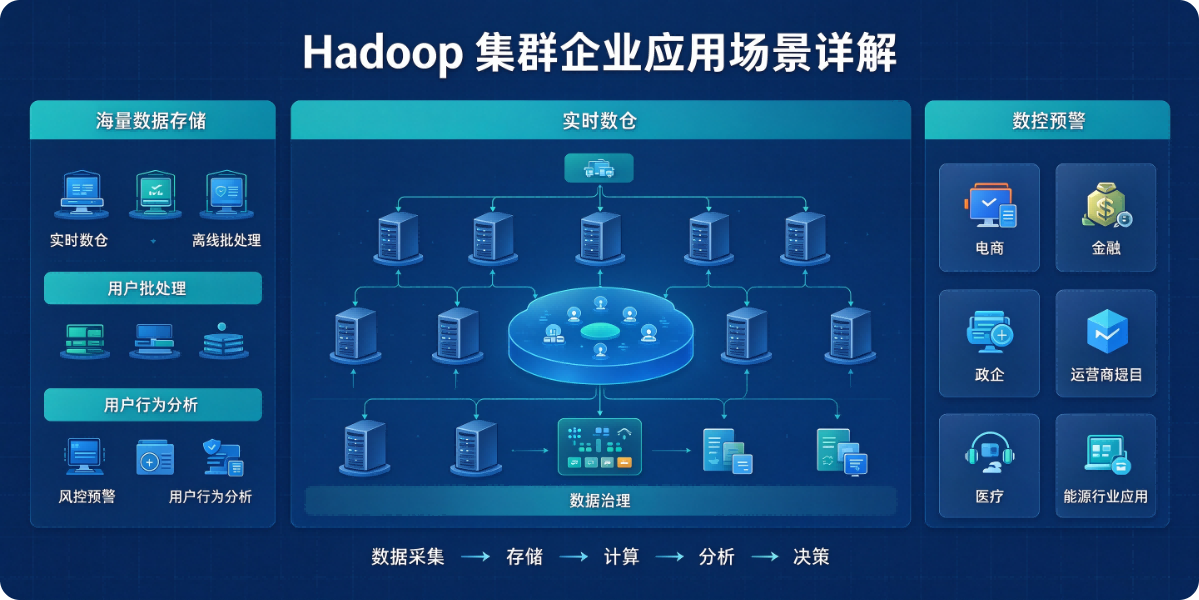
Hadoop 核心能力:海量数据分布式存储(HDFS)+ 分布式计算框架(MapReduce/YARN),主打低成本、高可靠、横向扩容,适合TB/PB 级、非实时、离线为主的数据场景;现在企业很少单独裸用 MapReduce,大多基于 Hadoop 底座搭建数据湖、数仓,上层跑 Spark、Hive、Flink、Hudi 等组件。
一句话定位:Hadoop 是传统大数据底座,适合海量冷 / 温数据长期存储、离线批量计算;实时场景一般搭配 Kafka + Flink。
1. 离线数据仓库(最主流场景)
绝大多数企业引入 Hadoop 的首要用途。
数据来源:业务数据库 MySQL/PostgreSQL、日志、埋点、第三方接口、ERP、CRM 等,通过 DataX、Sqoop、Canal 同步到 HDFS
组件:Hive(数仓 SQL)、YARN 资源调度、HDFS 存储,分层建设 ODS/DWD/DWS/ADS
用途:
经营报表、日 / 周 / 月汇总统计(销售额、订单量、用户留存、复购)
财务对账、渠道结算、代理商佣金计算
用户标签宽表加工,给画像、营销系统输出数据
特点:T+1 离线计算,不支持秒级实时;数据量大、计算逻辑复杂、跑一次耗时久
2. 用户行为分析 & 埋点日志分析(互联网、零售、APP)
采集:APP、小程序、网页前端埋点日志、Nginx / 后端服务访问日志
存入 HDFS 做长期归档,用 Spark/Hive 清洗、去重、会话拆分
产出:页面 PV/UV、点击路径、流失分析、版本效果 A/B 实验统计、渠道投放效果归因
优势:日志量巨大(每天几十亿条),HDFS 廉价存储,可以留存数月甚至数年日志,随时回溯复盘
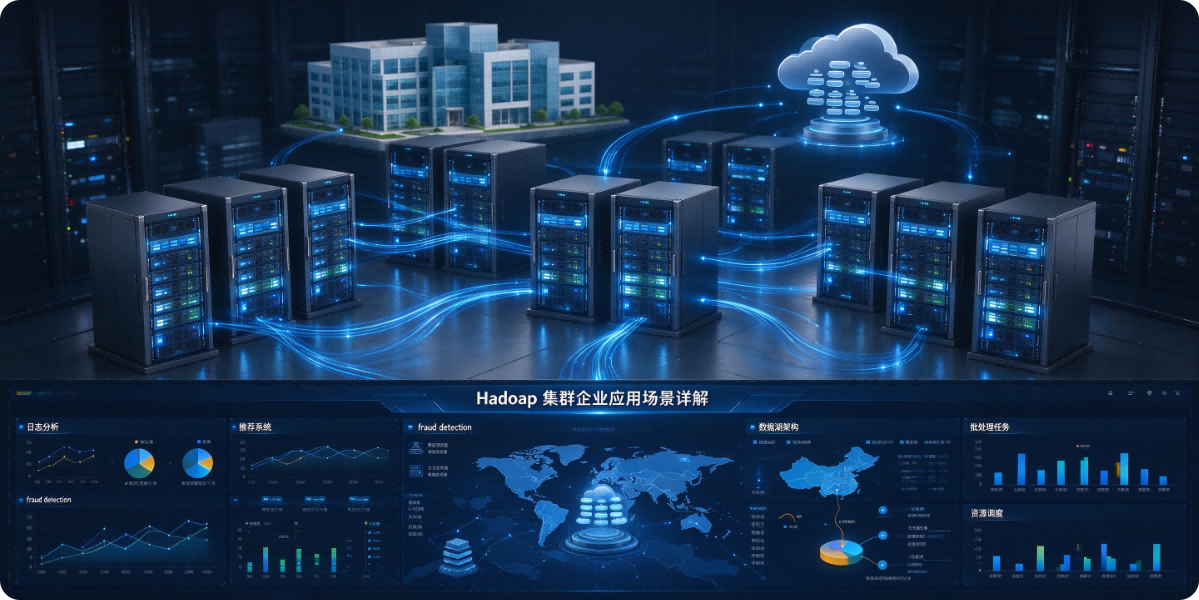
3. 数据湖存储底座(湖仓一体)
很多企业的数据湖底层就是 HDFS:
统一存储结构化、半结构化(JSON、Parquet)、非结构化数据(图片、音视频、文档、备份文件)
上层同时支持:Hive 离线 SQL、Spark、Flink 实时写入(Hudi/Iceberg)、Trino/Presto 即席查询
对比传统数仓:不用预先强建表结构,原始数据原样落盘,需要时再做 schema;适合业务多变、数据源杂的公司
现在云原生趋势下,很多新方案用对象存储替代 HDFS,但政企、传统大厂自建机房还是大量用 Hadoop+HDFS 做数据湖
4. 风控、反欺诈离线建模(金融、支付、电商)
金融、保险、支付、电商风控分两类:实时风控(Flink)+ 离线特征加工(Hadoop/Spark on YARN)
在 Hadoop 集群批量计算用户历史特征:近 30 天交易频次、跨地区登录、设备关联关系、历史逾期记录
特征存入 Redis / 特征库,供给实时风控引擎调用
离线跑模型训练样本,用 XGBoost、LR 等训练欺诈识别、盗刷模型;定期批量打分,生成风险名单
5. 物联网 IoT 海量时序数据存储与批量统计(制造、能源、车联网)
工厂传感器、电力设备、充电桩、车载传感器,每秒上报海量指标:温度、压力、电压、转速、位置
实时指标用 InfluxDB、TDengine 存最近短期数据做监控告警
历史全量原始数据写入 HDFS 长期保存
离线任务:按天聚合设备故障率、能耗统计、设备健康度分析、生产良率分析、故障根因回溯
制造业 MES 配套:海量生产时序数据归档、批量质检统计
6. 内容 & 多媒体资源存储、批量处理(媒体、短视频、监控)
HDFS 天然适合大文件存储:
视频文件、录音、图片、监控录像原始文件归档
批量任务:批量转码、图片抽帧、OCR 识别、音频文字提取、内容审核离线筛查
比如安防企业:摄像头录像长期冷备存储,按需批量检索分析
7. 日志中台 & 运维审计日志存储(政企、金融等强合规行业)
服务器日志、数据库审计日志、堡垒机日志、访问操作日志集中写入 HDFS
合规要求:审计日志必须保存 6 个月~3 年,不可随意删除、支持事后审计溯源
离线分析:暴力破解、异常登录、越权访问行为批量筛查
实时告警一般用 ELK,长期归档和批量审计交给 Hadoop
8. 基因、测绘、科研离线计算(科研院所、生物医药)
基因测序文件、遥感卫星影像、气象数据,单个文件极大,计算算力消耗高
HDFS 存储原始测序数据、遥感影像
YARN 调度算力,批量跑比对、拼接、特征提取算法;这类任务重 IO、重批量,非常契合 Hadoop 设计
9. 数据迁移、备份、冷数据归档
很多企业把 HDFS 当成低成本大容量存储池:
业务库历史冷数据(几年前订单、历史账单)从 MySQL 迁移到 HDFS,下线业务库,节省昂贵 SSD 数据库存储
作为二级备份介质,核心数据异地 Hadoop 集群灾备
❌ Hadoop 不适合的场景(避坑)
低延迟实时查询(毫秒级报表、实时大屏):优先 Flink、ClickHouse、Doris
高频随机读写、单行更新:HDFS 不擅长随机修改文件
小文件极多且无合并方案:Hadoop NameNode 压力巨大,是经典痛点
数据量很小(每天几十 GB 以内):Hadoop 运维成本高,不如直接用轻量 OLAP
✅ 企业落地现状补充
现在很少有人直接写 MapReduce 代码:
Hadoop = HDFS(存储) + YARN(资源调度)
上层运行:Spark、Hive、Flink、Hudi、Iceberg
两种路线:
传统自建:CDH、HDP(老版本)、CDP,政企、制造业、金融本地机房
新趋势:云原生大数据,HDFS 逐步被 S3 兼容对象存储替代,Hadoop 集群在新增项目里占比下降,但存量规模巨大