
Redis Cluster 原生分片集群:16384 哈希槽、Gossip 节点通信、自带故障转移,不要叠加哨兵;生产最低起步:3 主 3 从(6 节点),跨机架 / 跨可用区部署,避免单点故障域重合。 核心约束:只支持 db0,跨 slot 多 key 命令不支持;需要多 key 原子操作使用 HashTag
{tag}。
一、架构选型与节点规划
1. 拓扑原则
最小可用:3 主 + 3 从;每主至少 1 副本,主和副本不要同机 / 同 AZ,最好跨 3 个机架 / 可用区,保证单 AZ 故障不丢服务Redis
规模建议:单集群总节点建议 ≤ 60 个;节点过多 Gossip 消息风暴、故障检测延迟上涨;超大规模用 Proxy 模式(Predixy/Corvus) 或者拆分多集群
读写分离:Cluster 本身不自动路由读请求到从节点;客户端 / 代理层做读从,降低主节点 CPU 压力
一致性:异步复制,不保证强一致;业务允许短暂丢数据;强一致场景不要用 Cluster
2. 硬件 / OS 基础优化(非常关键,很多性能问题根源)
# 关闭透明大页 THP(必做,fork写时复制延迟杀手)
echo never > /sys/kernel/mm/transparent_hugepage/enabled
echo never > /sys/kernel/mm/transparent_hugepage/defrag

# 内核参数 /etc/sysctl.conf
vm.overcommit_memory = 1
net.core.somaxconn = 1024
net.ipv4.tcp_keepalive_time = 30
# 调高文件句柄
ulimit -n 65535
内存分配器:
jemalloc(默认),不要用 libc,减少内存碎片CPU:Redis 单线程核心,单实例不要绑太多核;一台机器多实例做好 CPU 隔离、NUMA 绑定
磁盘:持久化优先 SSD;机械盘 AOF rewrite 会严重卡顿
二、redis.conf 集群核心配置(可直接复制)
# 基础
port 6379
bind 0.0.0.0
protected-mode no
requirepass Redis@2026
masterauth Redis@2026
daemonize yes
pidfile /var/run/redis_6379.pid
logfile /var/log/redis/redis_6379.log

# 集群开关
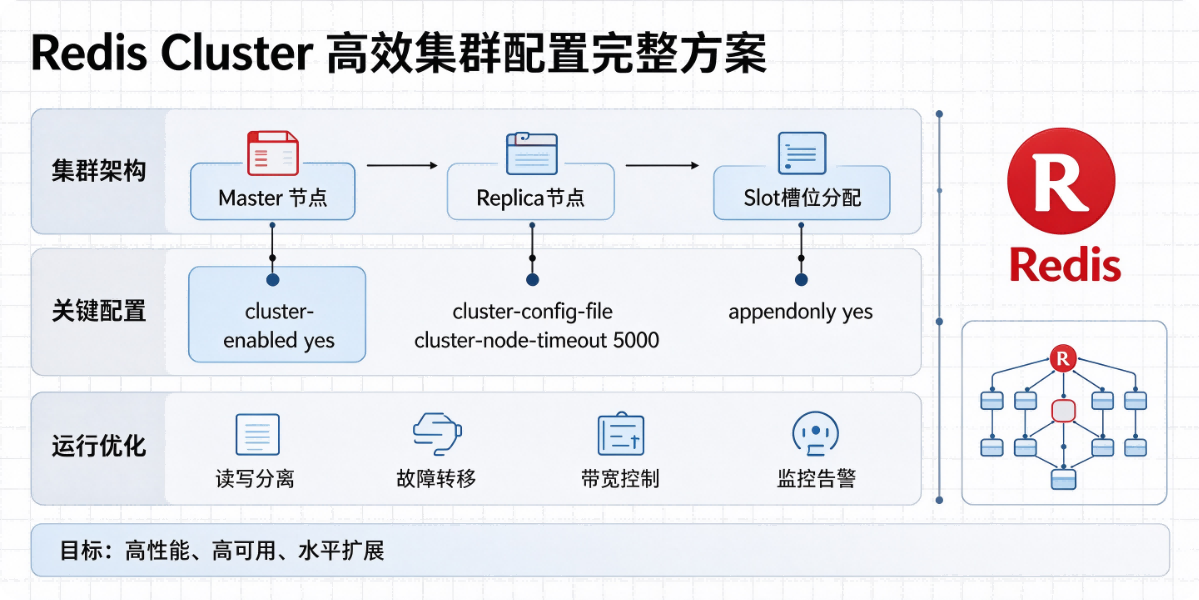
cluster-enabled yes
cluster-config-file nodes-6379.conf
cluster-node-timeout 15000               # 节点超时15s,主节点失联后开始故障转移
cluster-slave-validity-factor 10        # 从节点断连超过15*10=150s 不参与选主
cluster-migration-barrier 1             # 至少保留1个健康从,才允许副本迁移
cluster-require-full-coverage no        # ✅ 生产必开:部分slot不可用,其余slot继续提供服务,集群不全挂
cluster-allow-reads-when-down no        # 集群FAIL状态禁止写入,防止脑裂脏写

# 内存控制(单节点上限,预留fork内存)
maxmemory 12gb
maxmemory-policy allkeys-lru
maxmemory-samples 5

# 持久化策略(推荐RDB+AOF混合)
save 900 1
save 300 10
save 60 10000
appendonly yes
appendfilename "appendonly.aof"
appendfsync everysec
no-appendfsync-on-rewrite yes
auto-aof-rewrite-percentage 100
auto-aof-rewrite-min-size 64mb
aof-use-rdb-preamble yes
参数说明:
cluster-node-timeout:默认 15000(15s),不要太小,容易误判故障;内网稳定环境最低不低于 5scluster-require-full-coverage no:线上最重要配置,默认 yes,一个分片挂了整个集群不可用cluster-migration-barrier:副本自动迁移,均衡分片副本数量,避免有的主没从
三、创建集群命令
所有节点启动后,使用 redis-cli 一键创建(Redis 7+)
redis-cli --cluster create \
10.0.0.1:6379 10.0.0.2:6379 10.0.0.3:6379 \
10.0.0.4:6379 10.0.0.5:6379 10.0.0.6:6379 \
--cluster-replicas 1 -a Redis@2026
--cluster-replicas 1 = 每个主分配 1 个从节点,3 主 3 从
常用运维命令
# 查看集群状态
redis-cli -a xxx --cluster check 10.0.0.1:6379
redis-cli -a xxx -c -h 10.0.0.1 -p 6379
CLUSTER INFO
CLUSTER NODES

# 扩容:添加新master,reshard迁移槽
redis-cli --cluster add-node new_ip:6379 exist_ip:6379 --cluster-master-id xxx
redis-cli --cluster reshard exist_ip:6379

# 缩容:迁移完槽后删除节点
redis-cli --cluster del-node ip:port nodeid
-c参数:客户端自动跟随 MOVED 重定向,本地维护 slot 映射表
四、客户端选型(决定集群效率)
Java:Redisson(首选),内置集群路由、连接池、重试、读写分离;JedisCluster 可用但维护弱
Go:redigo、go-redis
Python:redis-py Cluster
不推荐裸客户端自己处理 MOVED/ASK,极易踩坑
连接池:每个节点独立连接池,控制连接数;不要无限创建连接
读写分离方案:客户端侧配置
readFrom=SLAVE,读请求打到从节点;注意从节点读是最终一致性
Proxy 方案(适合多语言、老旧客户端)
Predixy / Corvus / Redis Cluster Proxy:统一入口,客户端像访问单机 Redis,代理内部维护 slot 路由;代价多一层网络转发。
五、Key 设计与性能优化(重中之重)
哈希槽均衡:key 尽量随机,不要大量固定前缀;热点 key 单独处理
HashTag:
{order:10001}:pay、{order:10001}:status,大括号内内容参与 CRC16 计算,同 tag 落到同一个 slot,支持 mget/mset;不要把所有 key 放同一个 tag,退化成单点瓶颈避免大 key、大 list、大 hash;大 key 迁移、复制、过期阻塞主线程
慢命令:
keys *、hgetall、flushall禁止在线上集群执行;用 scan 分批遍历过期策略:集中过期会产生风暴,key 过期时间增加随机偏移
六、持久化、备份与故障
缓存场景:可关闭 AOF,只开 RDB;数据不能丢:RDB+AOF 混合(
aof-use-rdb-preamble yes)备份:定时执行
redis-cli --cluster backup,或者单独节点 RDB 文件拷贝故障转移:Gossip 多数派投票,主节点下线后,健康从节点自动升主;原主恢复后自动变成副本
脑裂风险:
cluster-allow-reads-when-down no,集群标记 FAIL 时禁止写入,防止网络分区双主写
七、监控指标(Prometheus+Grafana)
重点监控:
cluster_state:ok/failcluster_slots_assigned、cluster_slots_ok:16384 全部 ok 才正常主从延迟:
master_repl_offset差值内存碎片率、evicted_keys、expired_keys
命令耗时、redis_blocked_clients、client_longest_output_list
网络:节点间 Gossip 流量、TCP 重传
告警:cluster_state=fail、slot 丢失、主从延迟飙升、内存快打满、节点 down
八、常见坑清单
❌ 集群模式用
select 1:不支持多 db,只能 db0❌ 跨 slot mget、pipeline、事务:直接报错,必须 HashTag
❌ 节点端口不通:集群除 6379,还要开放
port+10000(集群总线端口)❌ 单节点内存过大:fork RDB 时 STW 卡顿,建议单实例控制在 16G 以内
❌
cluster-require-full-coverage yes:一个分片挂,整个集群不可用❌ 主从放同一台宿主机:机器宕机直接丢分片
九、部署方案对比
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢