
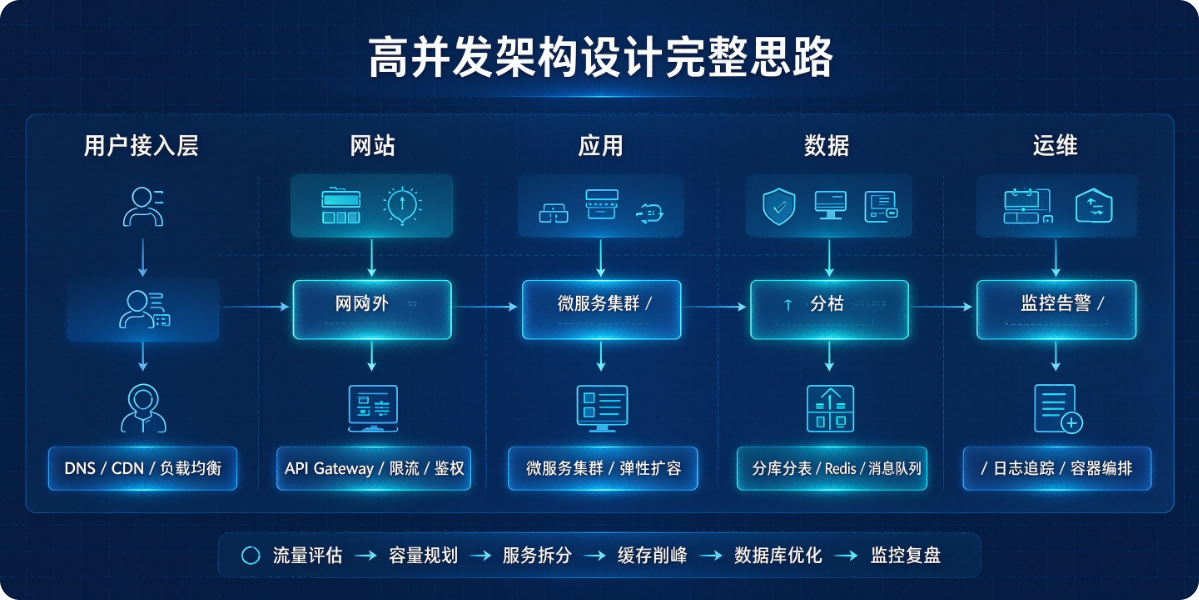
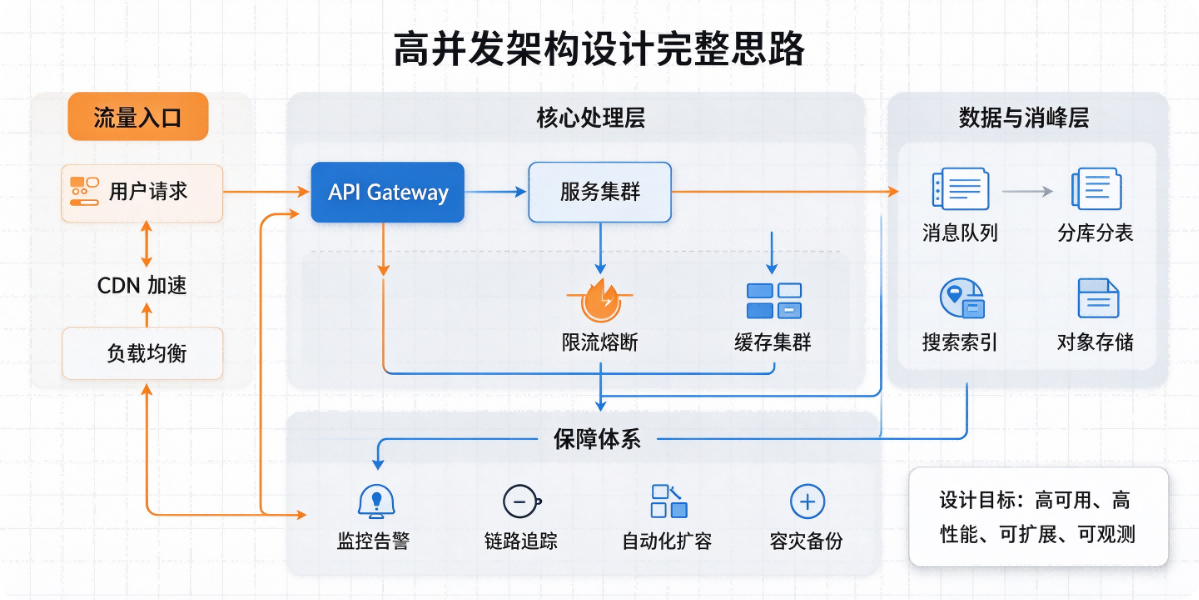
高并发核心目标:削峰、分流、隔离、兜底、水平扩展,不是单一技术,是一套分层组合方案,从接入层、应用层、缓存层、消息队列、数据库、业务编码、运维监控全链路处理。下面按层级拆解,附带选型和避坑点。
核心原则:能缓存就不计算,能异步就不同步,能分片就不分库,能限流就不硬扛,能降级就不雪崩。
一、接入层:流量第一道关口(网关 / CDN / 负载均衡)
1. CDN 静态资源加速
静态资源(图片、JS、CSS、静态页面、视频)全部丢 CDN,不让静态流量打到源站。
适用:商品图、首页静态资源、文档
收益:极大减少源站 QPS,降低带宽压力
2. 负载均衡(四层 + 七层)
四层 LVS:TCP 转发,性能极高,适合后端集群;
七层 Nginx/APISIX/Ingress:HTTP/HTTPS,支持路由、限流、SSL、灰度、熔断;
策略:轮询、加权轮询、最小连接数、IP 哈希(会话保持,尽量少用)。
3. 网关统一流量管控(重点)
网关层做前置防护,把无效流量挡在最外层:
限流:IP 限流、接口限流、用户维度限流(令牌桶、漏桶);
防刷:验证码、签名校验、黑名单、频率控制;
黑白名单、跨域、鉴权统一收口;
推荐:APISIX、Spring Cloud Gateway、Kong
二、缓存层:扛住大部分读流量(高并发读首选)
高并发系统大多是读多写少,缓存是性价比最高方案。
缓存分层
本地缓存(Caffeine、Guava Cache):JVM 内,毫秒级,无网络开销;适合热点不变数据(配置、字典);注意缓存一致性、内存溢出;
分布式缓存(Redis):最常用,支持集群、主从、哨兵;热点数据、用户会话、商品基础信息、计数;
集群分片:水平扩容;
持久化:RDB+AOF,防止宕机丢数据;
淘汰策略:LRU;
多级缓存:CDN → 本地缓存 → Redis
缓存经典问题(高并发必踩)
缓存穿透:查询不存在的数据一直打 DB → 方案:空值缓存、布隆过滤器;
缓存击穿:热点 key 过期,大量请求打 DB → 方案:互斥锁、永不过期、提前主动刷新;
缓存雪崩:大量 key 同时过期 / Redis 宕机 → 过期时间加随机偏移、Redis 高可用、熔断降级;
缓存更新策略:Cache Aside(旁路缓存,最推荐)、Read/Write Through、Write Back。
三、消息队列:异步化,削峰填谷(写并发利器)
核心思想:同步请求转异步,把瞬时高峰流量平滑拉长 适用场景:下单、支付回调、日志、短信通知、积分、消息推送、数据同步。
选型:RocketMQ(事务消息、高可靠,电商订单)、Kafka(超大吞吐,日志流)、RabbitMQ(灵活路由)、Pulsar;
要点:
消息幂等:避免重复消费;
消息可靠性:生产者确认、持久化、死信队列;
消费端限流、批量消费;
流量削峰:上游快速返回,下游消费者按自己能力慢慢消费;
注意:MQ 不能解决同步查询高并发,适合不需要实时返回结果的业务。
四、应用服务层:业务拆分 + 水平扩容
1. 微服务拆分 & 业务隔离
按领域拆分:订单、商品、用户、支付;核心服务和非核心服务隔离部署 好处:一个服务被打挂,不拖垮整个系统;资源独立、单独扩容。
舱壁模式(Bulkhead):线程池隔离,防止一个慢接口耗尽所有线程;
2. 无状态设计(扩容前提)
服务实例不要存会话、状态,session 放 Redis; 做到:任何请求可以路由到任意实例,随时加机器水平扩容。
3. 熔断、降级、超时控制(防雪崩)
雪崩:一个下游变慢 → 上游线程耗尽 → 整个服务不可用
熔断:下游失败率达到阈值,直接短路,一段时间不调用;
降级:非核心功能直接返回兜底数据(比如商品推荐、评论先不展示);
超时:所有 RPC、DB、Redis 调用必须设置超时时间;
组件:Sentinel、Resilience4j、Hystrix(不推荐新业务)
4. 请求合并、批量处理
多次小请求合并成一次批量请求:批量写 Redis、批量入库,减少 IO 次数; 适合:打点统计、日志上报。
五、数据库层:高并发读写的瓶颈重点
数据库往往是整个系统瓶颈,优化优先级:索引 > SQL 优化 > 读写分离 > 分库分表 > NewSQL
基础优化
合理索引,避免大事务、避免 select *;
控制行锁范围,减少锁等待;拆分长事务;
读写分离 主库写,从库读;一主多从,读请求分摊到从库; 问题:主从延迟,强一致性场景不能走从库;
分库分表(数据量大 + 写入高)
垂直分库:按业务拆分(订单库、用户库);
水平分表:按分片键(user_id、order_id hash)拆分;
中间件:Sharding-JDBC(客户端)、MyCat;
代价:分布式事务、跨分片查询、排序分页复杂,能不分就不分;
数据库限流 & 队列化 写入压力太大时,写入先进 MQ,消费端限流写入 DB;
备选:TiDB、OceanBase 这类分布式数据库,天然分片,适合有条件团队。
六、并发编程层面(代码层)
线程池合理配置,不要 new Thread;区分 IO 密集型、CPU 密集型;
减少锁粒度:分段锁、乐观锁(CAS)代替悲观锁;Redis 分布式锁控制竞争资源;
避免同步阻塞:异步非阻塞(WebFlux、Netty)适合网关、长连接;
连接池:DB 连接池、Redis 连接池设置合理上限,防止连接打满。
七、流量控制体系:限流、降级、熔断、排队(兜底防线)
一套组合防御:
限流:
粒度:全局限流、接口限流、用户 / IP 限流;
算法:漏桶(匀速流出)、令牌桶(允许突发流量,互联网最常用);
排队:秒杀场景,排队页面,把流量挡在外面;
降级:关闭次要功能、返回静态兜底页;
熔断:依赖故障时快速失败;
八、典型高并发场景架构示例(秒杀)
用户请求 → CDN → Nginx 网关(限流 + 防刷) → 服务集群(本地缓存) → Redis(库存预扣、热点) → MQ(下单消息) → 订单消费服务 → 分库订单 DB
核心:库存提前预热到 Redis,不直接查 DB;下单异步化;超卖用 Redis Lua 脚本保证原子。
九、监控、压测、预案(容易被忽略)
高并发架构不是设计完就完事:
压测:JMeter、Locust,模拟峰值流量,找到瓶颈;
监控指标:QPS、RT、错误率、线程数、连接数、缓存命中率、MQ 堆积、数据库慢 SQL;
告警:阈值告警;
容灾:多可用区部署、异地多活,单机房故障自动切换。
十、选型决策清单(快速判断方案)
十一、常见误区
上来就分库分表:分表复杂度很高,优先缓存、读写分离;
所有接口都异步:需要实时结果的不能 MQ;
无限扩容机器:数据库、Redis 是有上限的;
只做技术不做兜底:没有降级策略,一挂全崩;
忽略热点 Key:少量热点流量就能打崩 Redis。
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢