
核心选择原则
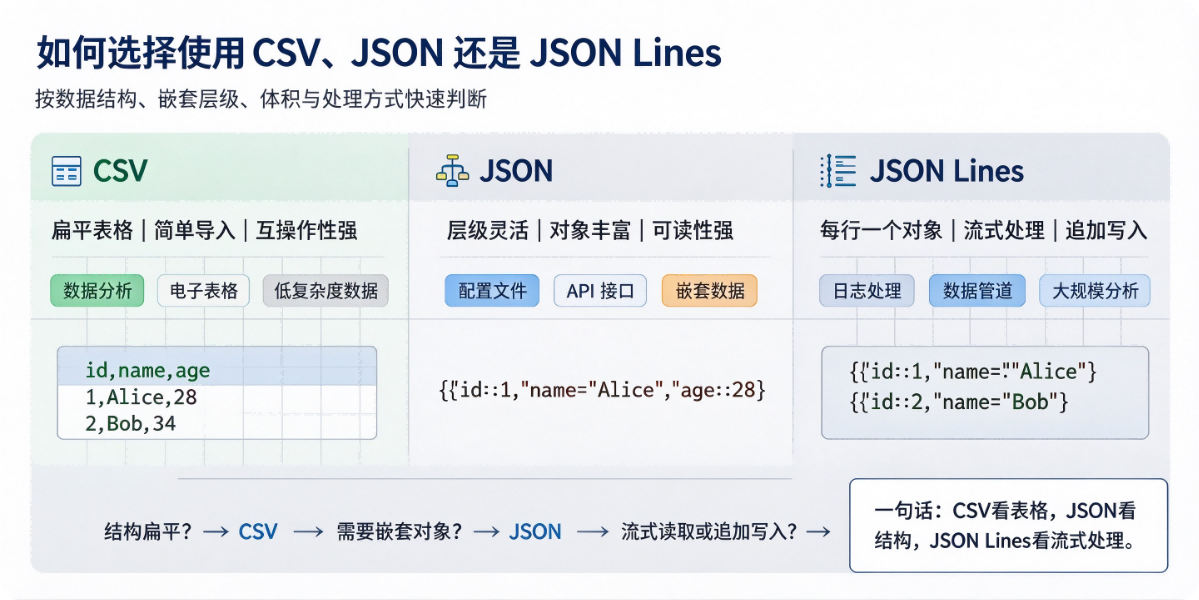
要 Excel 看、纯二维表、追求最小体积 → CSV 单次接口请求、配置、少量复杂对象、程序直接传消息 → JSON 海量记录、流式处理、日志 / 埋点 / CDC、有嵌套结构、怕 OOM → JSONL(JSON Lines)
下面分层给你判断流程、判断清单、避坑和示例,方便直接套到项目里。
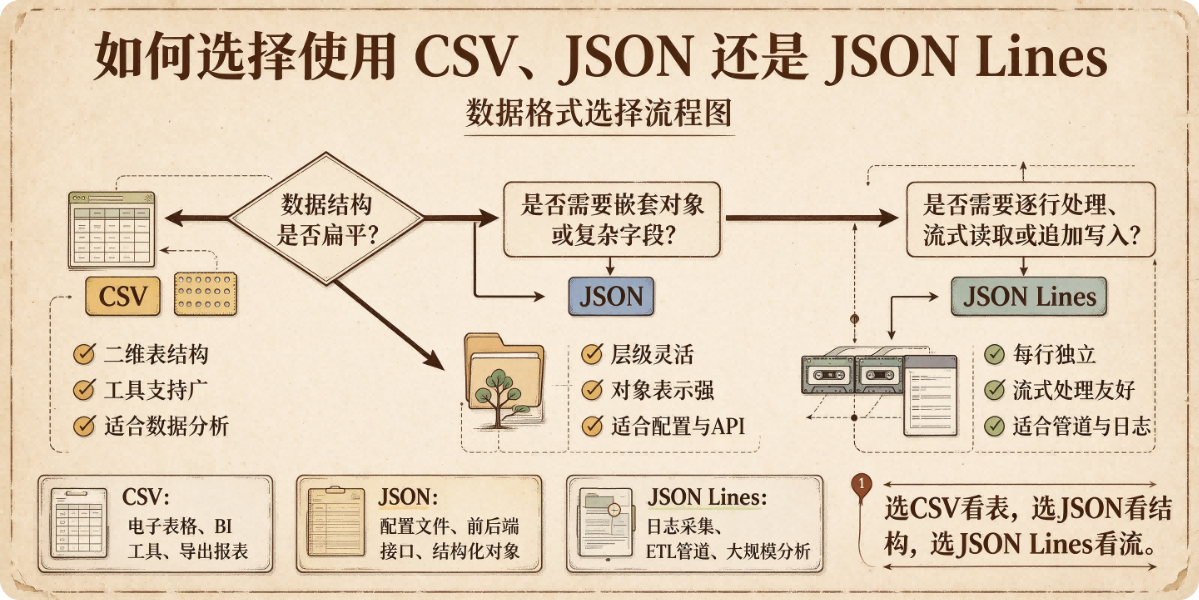
一、先看决策流程图(按顺序判断)
数据是不是给业务人员,需要用 Excel/WPS 打开、对账、做报表? ✅ 是 → 优先 CSV ❌ 否,继续往下
数据是单次请求 / 单次返回,条数不多(几十、几百条),用于 API、配置文件? ✅ 是 → 优先 JSON ❌ 否,继续往下
数据量大(上万、百万、千万级),需要逐行流式读取,不能一次性全加载进内存?
同时:存在嵌套、数组、层级结构(一条记录里包含子列表)→ JSONL
同时:完全扁平、没有任何嵌套 → 二选一:CSV(体积更小) or JSONL(自描述,不怕列顺序乱)
边界提醒:扁平大数据也不是必须 CSV,很多数据湖、数仓团队宁愿用 JSONL,牺牲一点存储空间,换取自带 key,不怕表头丢、不怕字段顺序变更。
二、分场景详细判定清单
✅ 选 CSV 的场景
适合全部满足:
数据是扁平二维表,没有嵌套、没有数组
目标:报表导出、运营对账、导入 BI、Excel 查看
优先诉求:文件更小、简单、工具开箱即用
不适合:
字段内容里大量逗号、换行、引号(转义坑多,极易错位)
字段经常新增、顺序经常调整(CSV 强依赖列位置,表头丢了直接废掉)
存在嵌套结构
例子:用户对账表、销售日报、简单库存清单
✅ 选标准 JSON 的场景
适合满足:
单次传输,记录数量不大(接口返回、配置)
存在嵌套 / 子对象 / 数组
双方都是程序对接(前后端、微服务调用)
一次性读取整条文档,不需要流式逐行处理
不适合:
上万条以上打包成一个
[{},{}]大数组(极易 OOM,解析慢)持续追加写入(追加到 JSON 数组尾部非常麻烦,要改文件末尾)
例子:HTTP REST 接口返回、应用配置文件、单条订单详情(订单 + 收货地址)
✅ 选 JSONL(JSON Lines)的场景
适合满足任意一条:
日志、埋点、审计事件、CDC binlog 变更数据,源源不断追加写入
百万 / 亿级记录,Spark/Flink/DuckDB/ClickHouse 导入,流式消费
每条记录独立,一条解析失败,不影响其他数据
需要 JSON 的嵌套能力,又不能一次性加载全部数据
不适合:
需要给运营用 Excel 打开查看
追求极致最小存储(同等扁平数据比 CSV 大)
例子:业务埋点日志、数据库同步 CDC 数据、离线数据湖原始层存储、Kafka 消息落盘
三、高频边界难题怎么选(重点)
1. 数据是扁平结构,但是字段经常新增、顺序会变
👉 优先 JSONL CSV 靠列序号识别,新增字段、调整顺序,老程序很容易读错;JSON/JSONL 靠 key,顺序无关。代价就是文件比 CSV 大一点。
2. 数据有嵌套,但是条数很多(几千、上万条)
👉 坚决不要标准 JSON 大数组,选 JSONL 很多新手踩坑:[{"order":{}, "goods":[...]}, ...] 几十 MB 的大 JSON 数组,解析直接 OOM。JSONL 一行一条订单,流式解析。
3. 数据里面大量带逗号、引号、换行文本(评论、备注)
👉 尽量避开 CSV!CSV 转义处理很容易出错,优先 JSONL。
4. 既要给开发程序读,偶尔运营也要抽查看一下
方案 A:导出两份,一份 CSV 给运营,一份 JSONL 给大数据平台
方案 B:用 JSONL 给程序,抽查时写个小脚本把 JSONL 转成 CSV 给运营
5. 消息队列(Kafka/RocketMQ)单条消息载体
👉 单条消息体用 JSON;如果消息落盘到文件持久化,文件格式用 JSONL。
四、对比取舍速查表
五、补充工程实践建议
大数据数仓 ODS 原始层:优先 JSONL,保留原始结构,不提前拍扁;清洗层再输出 CSV/Parquet
对外给客户导出报表:CSV
API 响应:标准 JSON;如果接口批量返回上万条,建议改成分页,或者返回下载链接,文件用 JSONL
存储选型:追求压缩后极致性能,长期归档,这三个都不如 Parquet、ORC(列式存储),这三个只是文本交换格式
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢