
一、硬件分级说明(Q4_K_M 量化,最通用)
超低配置(4GB 内存 / 无独立显卡):≤3B 参数,手机 / 轻薄本 / 树莓派可用
入门笔记本(8GB 显存):4B~8B 参数,主流首选
中端台式(12~16GB 显存):8B~14B 参数,兼顾速度与能力
二、纯文本对话模型(分档)
1)超轻量(1B~3B,4GB 内存即可跑,CPU 流畅)
2)主流均衡(4B~8B,8GB 显存首选,中文最优)
3)进阶轻量 MoE(仅激活少量参数,16GB 内存)
Qwen3-30B-A3B:仅 3B 激活,推理速度≈3B,能力接近 30B;Q4 约 18GB;
ollama run qwen3:30b-a3b
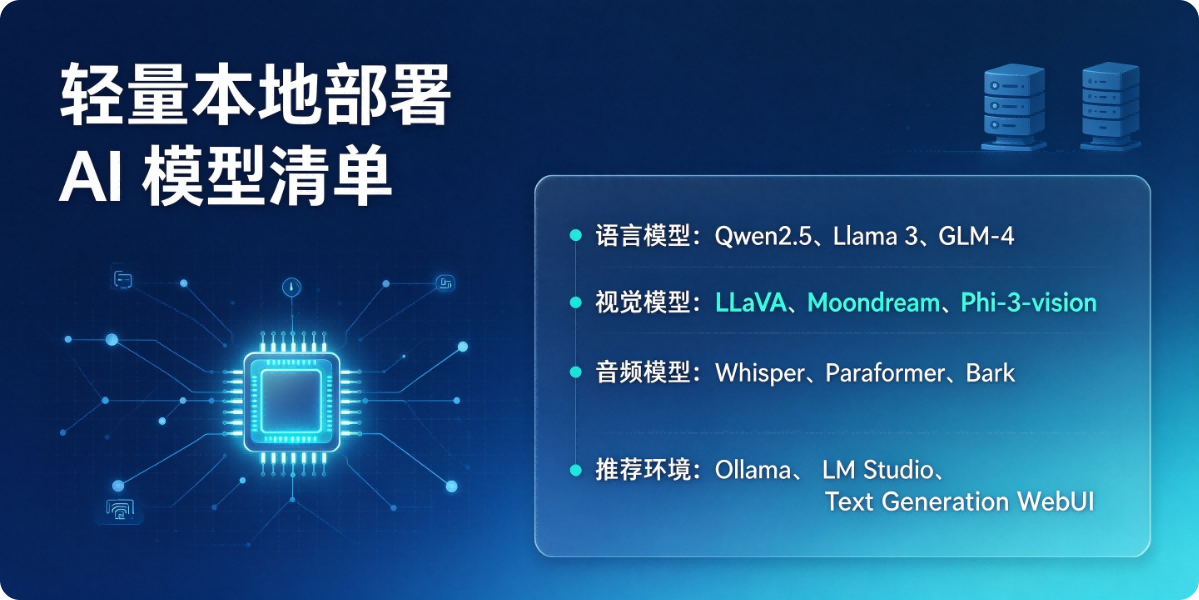
三、轻量多模态(图文识图,本地离线看截图 / 表格)
1)超小 VLM(2GB 以内,笔记本 CPU 可跑)
Moondream2(1.4B) Q4 仅 830MB;看图问答、截图识别;命令:
moondreamOllamaMiniCPM-V-2B 2B 多模态;中文识图强;支持公式、表格识别
2)均衡多模态(7B,8GB 显存流畅)
Qwen2.5-VL-7B 图文解析、OCR、PDF 截图、网页截图;命令:
qwen2.5-vl:7b阿里云开发...Gemma3-12B(多模态版) 图文 + 音频,统一架构;Q4 约 6.6GB,12GB 显存稳跑
四、专项垂直轻量模型
1)代码专用(本地写脚本、排错)
Qwen2.5-Coder-3B(3B,4GB 内存):
qwen2.5-coder:3bDeepSeek-Coder-6.7B:轻量代码调试,8GB 显存可用
2)RAG 嵌入模型(知识库向量检索,极小体积)
EmbeddingGemma2(740M):文本 + 图片 + 音频多模态向量;仅 191MB 内存占用
BGE-M3(0.5B):中文语义检索首选,CPU 秒级推理
3)语音本地模型(离线语音转文字)
Whisper-small(1.1B):中英语音转写;量化后仅 600MB
SenseVoice-small:中文方言识别,端侧离线首选
五、一键部署工具(零环境配置)
Ollama(首选):Windows/macOS/Linux 一键安装,自动下载 GGUF 模型,自带 OpenAPI;一条命令启动模型
LM Studio:可视化界面,支持 GGUF/GPTQ,可切换模型、调节量化
OpenClaw:面向 Agent,支持多模型调度、RAG 集成
RAGFlow / Dify:搭配轻量模型做本地私有知识库(文档问答)
六、快速选型建议(直接照抄)
4G 轻薄本 / 手机:MiniCPM5-2B + Moondream2(看图)
8G 游戏本(日常聊天 + 中文 + 代码):Qwen3:8B
数学 / 代码调试:DeepSeek-R1:8B
截图 OCR、解析表格:Qwen2.5-VL:7B
知识库 RAG:Qwen3-4B + BGE-M3 嵌入模型
七、补充说明
优先选择 Q4_K_M 量化:平衡速度、显存、精度;不要用 Q2(损失太大)
Apple Silicon(M 系列)优先用 MLX 版本,内存共享,速度提升一倍
全部模型均为 Apache2.0/MIT 开源,无版权限制,可私有化部署
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢