
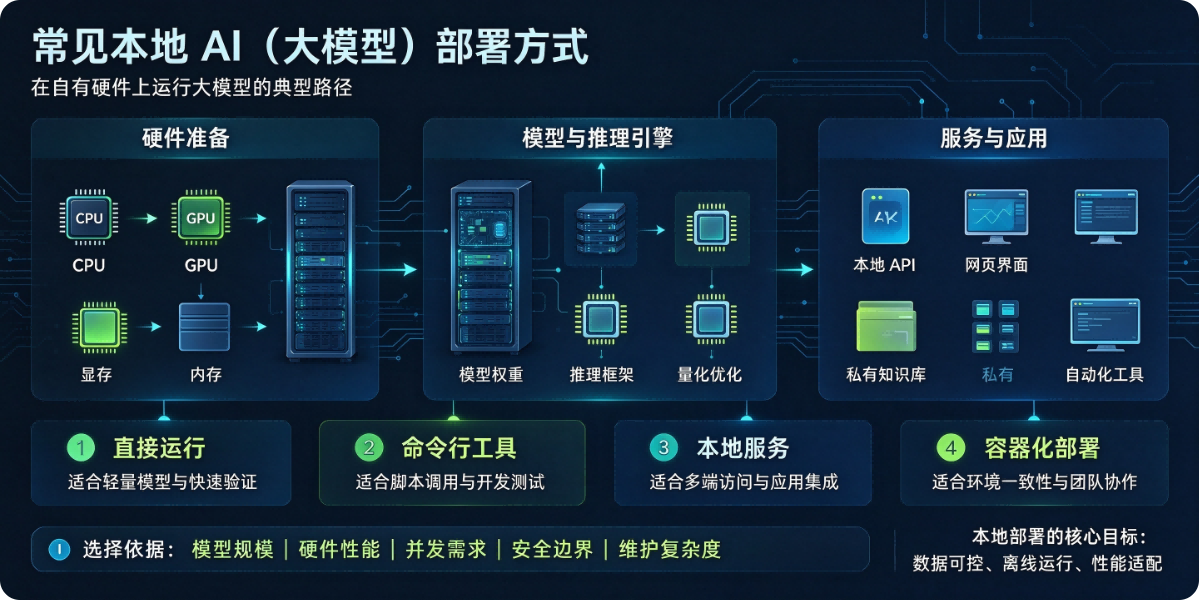
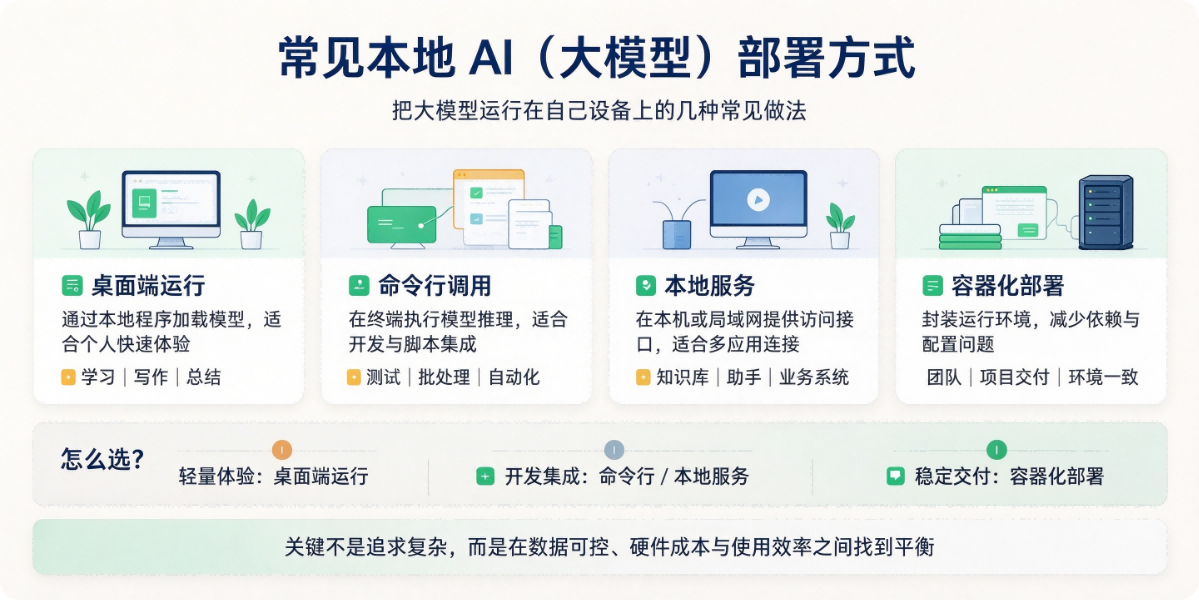
按上手难度、定位分成:桌面 GUI 一键部署、命令行工具、底层推理引擎、Python 原生框架、容器化 API 服务、专项加速框架、硬件原生 SDK七大类,覆盖个人把玩、开发调试、企业生产、边缘嵌入式场景。
1. 桌面 GUI 一键式(新手首选,零代码)
适合不想碰命令行,Windows/Mac 直接聊天测试
LM Studio:图形化模型市场,一键下载 GGUF,自带聊天窗口,可开启本地 OpenAI 兼容 API;Mac、Windows 友好,M 芯片自动 Metal 加速
GPT4All / Jan:纯离线桌面客户端,内置模型商店,轻量化,低配笔记本、CPU 也能跑小模型
优点:开箱即用;缺点:并发弱,不适合做多用户后端服务
2. Ollama(目前开发者最主流)
跨平台(Win/Mac/Linux)单二进制工具,一条命令拉取、启动模型,自带 OpenAI 兼容 API:http://localhost:11434,底层默认封装 llama.cpp
ollama pull qwen2.5:7b
ollama run qwen2.5:7b
搭配 Open-WebUI / AnythingLLM 做网页前端、RAG 知识库
适合:个人开发、本地 Agent、IDE 代码助手、局域网小范围共享
局限:高并发吞吐弱,多人生产服务不推荐
3. 底层推理引擎(可控度最高)
llama.cpp
C/C++ 实现,GGUF 量化标准的源头引擎,支持 CPU、CUDA、Metal、Vulkan、昇腾 CANN、寒武纪等超多硬件;支持 CPU/GPU 分层卸载、2bit~8bit 量化;自带 llama-server 提供兼容 OpenAI 接口,适合嵌入到自研程序、NAS、嵌入式设备。
门槛偏高,参数调优多,适合深度调优、边缘移植
MLX(Apple Silicon 专属)
苹果官方框架,M1/M2/M3/M4 Mac 上跑模型,利用统一内存,比 llama.cpp 在苹果芯片上速度更强,mlx-lm 是常用封装库
4. Python 原生框架(二次开发、实验、微调)
基于 PyTorch 生态,直接加载 HuggingFace 格式权重(safetensors/bin)
Transformers + accelerate + bitsandbytes:最原生方案,支持 4/8bit 量化、GPU 分片加载;适合做模型改造、SFT 微调、自定义推理逻辑;缺点:上手复杂,原生推理速度一般,需要自己写接口服务
AutoGPTQ / AWQ:专门的量化推理库,GPU 上速度优于原生 transformers
5. 容器化兼容 API 服务(企业私有化、平滑迁移)
LocalAI:Docker 一键部署,兼容 OpenAI 接口,后端可对接 llama.cpp、vLLM、Stable Diffusion;可以同时支持 LLM、Embedding、文生图;老业务不用改代码,直接把 api 地址切成本地,适合内网私有化部署、信创环境
6. 高性能生产推理框架(高吞吐、多并发、服务器 GPU)
面向多用户、API 服务、批量任务,核心解决并发和显存利用率
vLLM:PagedAttention + 连续批处理,吞吐远高于 Ollama/llama.cpp,NVIDIA GPU 首选生产方案,支持 GPTQ/AWQ 量化、多卡分布式;企业内部服务、RAG 后端首选
SGLang:侧重结构化输出、JSON、工具调用、多模态,前缀缓存能力强,Agent 场景优势明显
TensorRT-LLM:英伟达官方,极致 GPU 性能,适合对延迟要求极高的专业服务器
7. 其他专项部署
WebUI 套壳方案:Open-WebUI、Text-generation-webui(oobabooga),前端丰富,支持插件、RAG、LoRA 加载,底层可切换 llama.cpp/exllama/vLLM 后端
边缘 / 移动端部署:NCNN、MNN、TNN;手机、RK3588 等嵌入式板子跑轻量化模型
多模态专项:Stable Diffusion / ComfyUI(文生图)、Whisper.cpp(语音转写)
快速选型参考
补充
本地 AI 部署的两大主流模型格式:
GGUF:llama.cpp/Ollama/LM Studio 使用,适合消费级电脑、CPU、Mac
Safetensors:HuggingFace、vLLM、TensorRT-LLM,多用于 NVIDIA GPU 生产环境
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢