
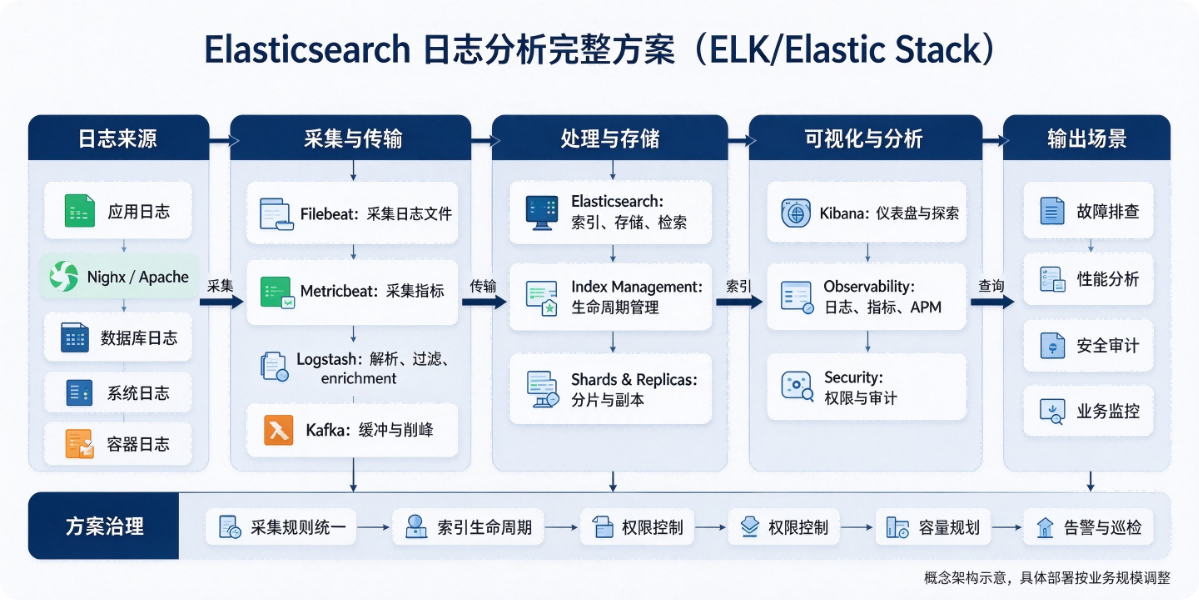
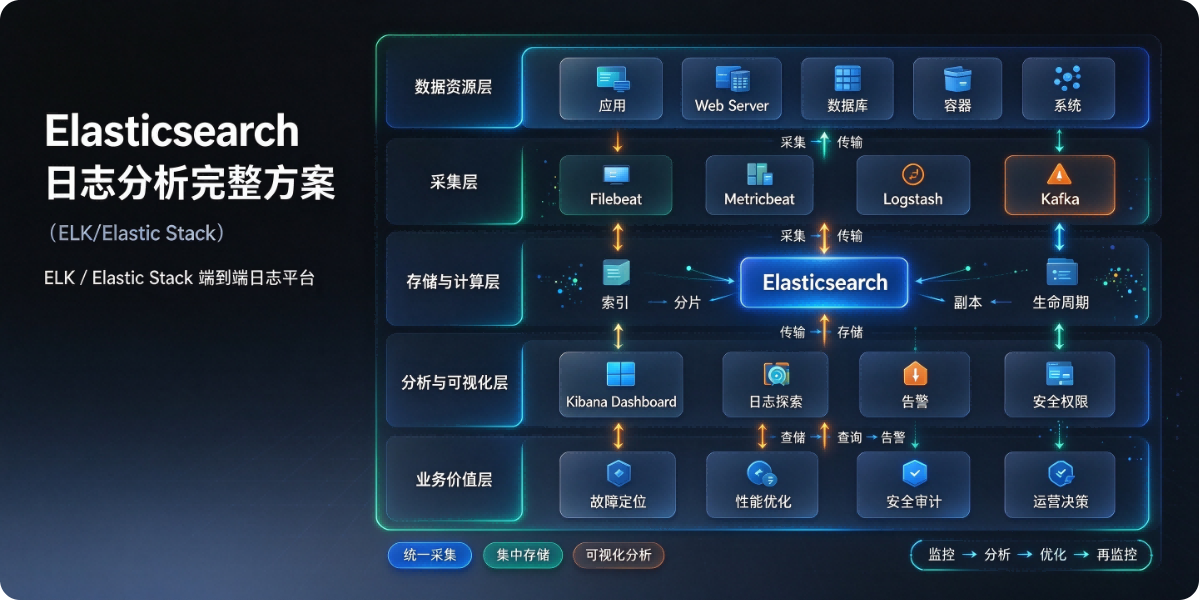
核心链路:应用日志 → 采集 → 清洗解析 → ES 存储索引 → 查询 / 聚合分析 → Kibana 可视化 + 告警 Elasticsearch 负责存储、倒排索引、全文检索、聚合统计;它本身不采集日志,需要搭配采集、处理、UI 组件一起工作Elastic。
一、架构选型(3 种常用方案)
方案 1:简单小集群(推荐入门)
Filebeat → Elasticsearch(Ingest Pipeline) → Kibana
Filebeat:轻量采集,部署在业务机,监听日志文件,资源占用极低,自带断点续传、背压控制;支持多行合并(Java 堆栈)、容器自动发现Elastic
Ingest Pipeline:ES 内置预处理,Grok/Dissect/json 处理器,在写入 ES 之前解析日志,不用单独部署 Logstash
适合:日量千万级以内、日志格式不算复杂
方案 2:标准生产架构(中大数据量)
Filebeat → Kafka → Logstash → Elasticsearch → Kibana
Kafka 做削峰缓冲,防止日志洪峰打挂 ES;解耦采集和处理
Logstash:强大过滤、Grok、GeoIP、字段富化、分支路由、丢弃无用日志;适合非结构化、格式杂乱的日志
适合:多业务、日亿级日志、复杂清洗逻辑
方案 3:新一代 Elastic Agent + Fleet
Elastic Agent(Fleet管理) → ES 统一采集日志、指标、安全数据,Kibana 里集中管理所有 Agent 策略,云原生 / 容器场景首选,替代分散的 Filebeat+MetricbeatElastic
✅ 8.x 新特性:LogsDB,日志专用索引模式,列存 + ZSTD 压缩,存储节省最高 65%,日志场景优先开启Elastic
二、分步落地
1. 日志规范(最优先!)
优先输出 JSON 结构化日志(logback/log4j2、Python logging、Nginx json 格式),自带 @timestamp、log.level、service.name、trace.id、message 字段,无需复杂 Grok 解析,检索效率最高。 非结构化文本日志才需要 Grok/Dissect 切割字段。
2. 采集:Filebeat 最简示例
# filebeat.yml
filebeat.inputs:
- type: filestream
  paths:
    - /opt/app/logs/*.log
  multiline.type: pattern          # 合并Java异常堆栈
  multiline.pattern: '^[0-9]{4}-'
  multiline.negate: true
  multiline.match: after
processors:
  - add_fields:
      fields:
        service: order-service
output.elasticsearch:
  hosts: ["http://es1:9200"]
  pipeline: "log-parse-pipeline"   # 指定Ingest解析管道
3. 清洗解析:Ingest Pipeline(ES 内置)
在 Kibana → Stack Management → Ingest Pipelines 创建,也可以用 API 创建。 示例:解析 Nginx 日志,用 dissect(性能高于 grok)
PUT _ingest/pipeline/nginx-log-pipeline
{
  "processors": [
    {
      "dissect": {
        "field": "message",
        "pattern": "%{client_ip} - %{user} [%{@timestamp}] \"%{method} %{path} %{proto}\" %{status} %{size}"
      }
    },
    {
      "date": {
        "field": "log_time",
        "formats": ["dd/MMM/yyyy:HH:mm:ss Z"]
      }
    },
    { "remove": {"field": "message", "ignore_missing": true} }
  ]
}
grok:正则语法,灵活,性能差一点,适合自定义复杂格式dissect:分隔符切割,速度快,格式固定优先用json:直接把 message 解析成 json 对象
4. ES 索引与生命周期(ILM,日志必配)
日志是时序数据,禁止单索引无限膨胀,推荐使用 Data Stream + ILM 索引生命周期管理:
Data Stream:自动按时间滚动,底层自动生成后备索引
logs-*-000001ILM 策略示例:
热阶段:写入、查询
温阶段:7 天后,迁移到温节点,冻结,降低资源开销
冷阶段:30 天后,归档
删除:90 天后自动清理旧日志
模板(Index Template):统一设置分片、副本、mapping、开启 LogsDB,匹配
logs-*
索引命名规范:
logs-{service}-*,例如logs-order,logs-nginx,logs-gc
5. 查询分析(DSL / KQL / ES SQL)
KQL(Kibana Discover 里直接写,最常用)
log.level:ERROR AND service.name:order-service AND @timestamp > now-1h
trace.id: "abc123456"
message: "timeout"
聚合统计 DSL(统计最近 1 小时错误数,按 5 分钟分桶)
GET logs-order/_search
{
  "size": 0,
  "query": {
    "bool": {
      "filter": [{"range": {"@timestamp": {"gte": "now-1h"}}}, {"term": {"log.level": "ERROR"}}]
    }
  },
  "aggs": {
    "time_bucket": {
      "date_histogram": {"field":"@timestamp","fixed_interval":"5m"}
    }
  }
}
常用分析场景:
全文检索报错关键词、链路追踪 traceId 串联全链路日志
统计错误码分布、TOP 慢请求、异常峰值
按服务、IP、用户、接口分组统计 QPS、错误率
6. Kibana 可视化 & 告警
Discover:实时查看、检索、过滤原始日志,支持 tail 实时流
Visualize / Dashboard:做折线图(错误率)、饼图(状态码)、TOPN IP 面板
Alerting 告警规则:
阈值告警:5 分钟内 ERROR 日志 > 50 条
异常检测(ML):自动识别日志突增突降
通知:webhook、钉钉、企业微信、邮件
三、生产最佳实践(避坑重点)
写入侧
Filebeat 开启 persist 跟踪文件偏移,防止重复采集、丢日志
高并发一定要加 Kafka 缓冲;不要让业务直写 ES
丢弃无用日志:健康检查 200、调试日志,减少存储和压力
ES 集群规划
角色分离:master、data_hot、data_warm、data_cold、ingest 节点
日志分片:单个分片建议 20~50G;分片过多会加重集群负担
关闭不需要的字段索引:只对检索字段开启 index:true,大文本只存不索引
开启 LogsDB,日志场景收益巨大
查询侧
所有查询必须带时间范围,不带时间范围的查询是日志平台杀手
优先使用结构化字段过滤(log.level、service),少用全文 match
禁止超大时间范围、深度分页;用 search_after 滚动
权限与安全
开启 ES 安全认证,不同业务索引做 RBAC 权限隔离
审计日志、慢查询日志单独采集监控
四、常见排查方向
日志收不到:Filebeat registry、输出地址、pipeline 解析失败标签
_grokfailureES 写入变慢:分片过多、无 ILM、热节点资源打满、未加缓冲队列
查询慢:时间范围太大、未结构化、分片过大、没有合理索引 mapping
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢