
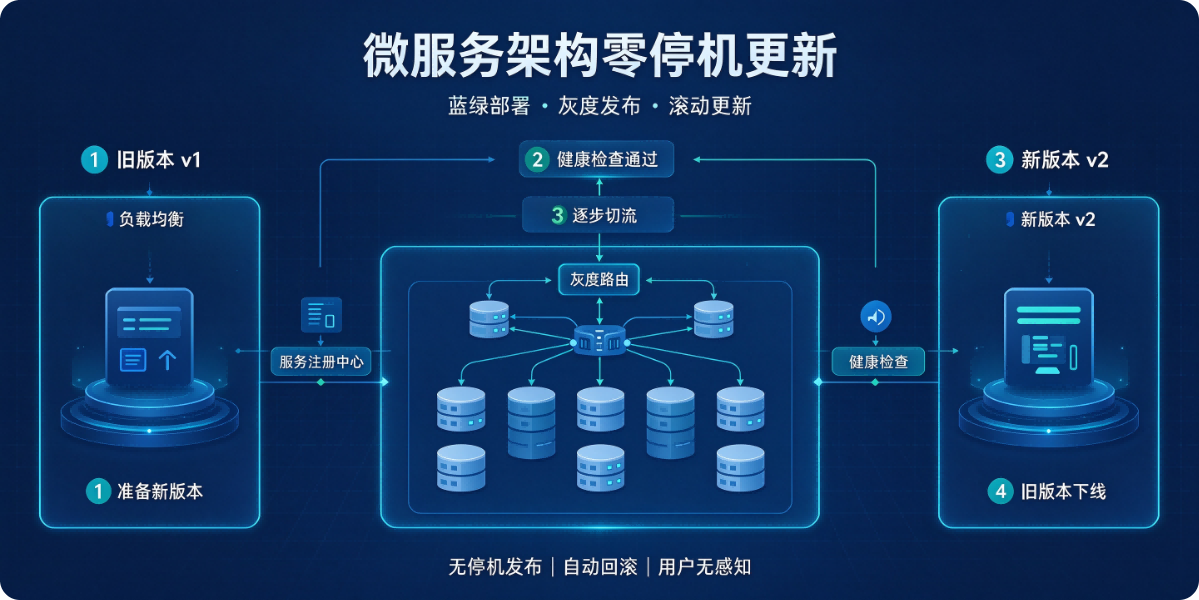
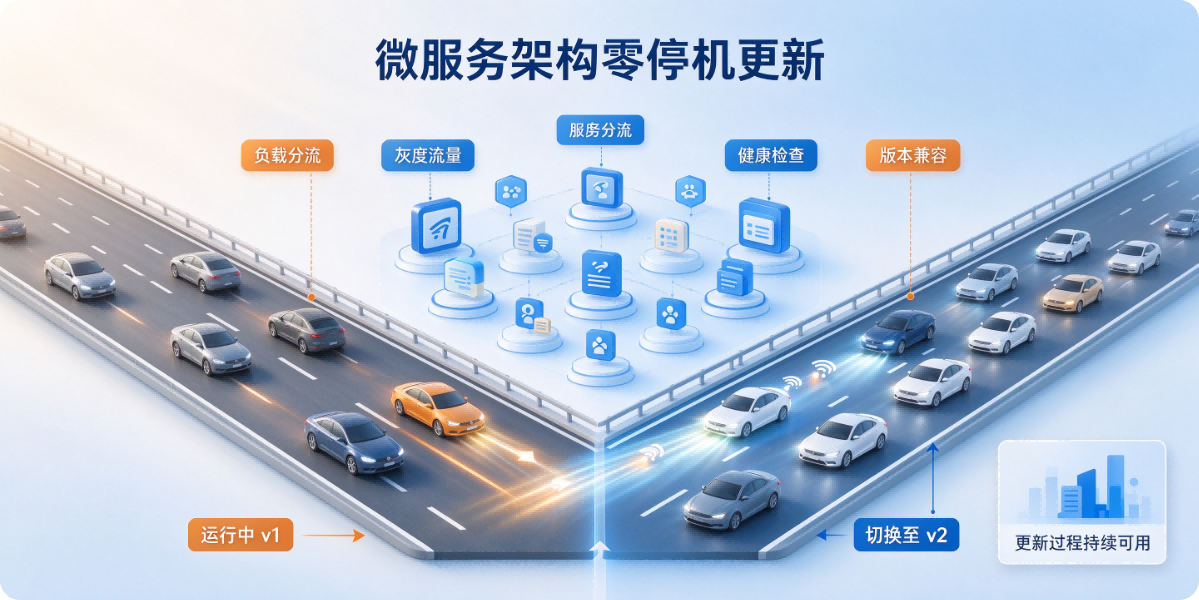
核心目标:新版本上线过程中,不中断对外服务,请求不会失败,用户无感知。本质思路:新旧版本同时并存,流量平滑切换,验证无误后再下线旧版本。
前提:微服务本身是无状态服务(业务状态放 Redis、数据库等共享存储,本地不存会话);有状态服务(有本地数据、本地缓存、长连接)零停机会复杂很多,一般依赖主从、分片迁移。
下面从原理、主流策略、配套组件、风险点、完整流程依次说明。
一、核心基础组件
零停机更新不是单一技术,是一套组合:
注册中心:Nacos / Consul / Eureka /etcd,服务实例上报健康状态,提供服务发现
负载均衡 / 网关:Spring Cloud Gateway、Kong、APISIX、Envoy(Istio),负责流量分发
健康检查:HTTP/TC P/Readiness 探针,判断实例是否就绪,可以接收流量
编排平台(常用):Kubernetes(原生支持滚动更新,是工业界主流)
配置中心:Nacos/Apollo,配置变更和代码发布解耦
关键两个探针(K8s 概念,通用)
LivenessProbe 存活探针:实例是否还活着,挂了就重启
ReadinessProbe 就绪探针:实例启动完成、初始化完毕,才允许接入流量;刚启动但没就绪,网关 / 注册中心不会给它发流量
二、4 种主流零停机发布策略
1. 滚动更新(Rolling Update,最常用、默认方案)
逻辑:逐个替换实例,先启动一个新版本实例 → 就绪检查通过 → 接入流量 → 再停止一个旧版本实例;循环直到全部替换完成。 ✅ 优点:资源占用低、简单稳定;大部分业务默认选择 ❌ 缺点:新旧版本同时在线一段时间,必须保证版本兼容(向前兼容、向后兼容);接口、数据库表结构不能不兼容;否则一部分请求走新、一部分走旧,出现数据错乱。
兼容要求:
新增字段不能强制;删除字段先保留、后期再清理
RPC/HTTP 接口入参、出参向下兼容
DB 变更采用多阶段变更(先加字段、代码兼容、再清理旧字段)
K8s Deployment 默认就是滚动更新,可以配置 maxSurge(最多额外多出几个新实例)、maxUnavailable(最多允许多少旧实例不可用)。
2. 蓝绿发布(Blue/Green)
逻辑:
Blue:当前线上稳定版本(全量实例)
Green:全新一套同等规模新版本实例
部署完整 Green 集群,独立跑起来,自测、冒烟
网关 / 注册中心一次性把流量全部切到 Green
观察指标(错误率、耗时),正常则保留 Green,后续删除 Blue;异常立刻切回 Blue,秒级回滚
✅ 优点:切换瞬间完成;回滚极快;不存在新旧版本共存,规避版本兼容问题 ❌ 缺点:双倍资源;流量一刀切,一旦新版本有隐藏问题,全部用户受影响;适合变更风险高、不想处理版本兼容的场景
3. 金丝雀发布(Canary / 灰度发布)
逻辑:先切一小部分流量到新版本,验证一段时间,没问题再逐步放大流量,直到全量;异常则把小流量切回去。 流量切分方式:
按比例:10% 流量走新版本,90% 旧版本
按特征:特定用户 ID、租户、请求头、地域路由到新版本(定向灰度) ✅ 优点:风险最小,先小范围验证;生产环境真实流量验证 ❌ 缺点:架构复杂,需要流量染色、路由规则;同样存在新旧共存,要求版本兼容
Istio、APISIX、Spring Cloud Gateway 都支持按权重、请求属性做金丝雀路由
4. 影子发布(Shadow,流量镜像)
不属于上线切换,是预验证手段,常配合金丝雀: 线上真实流量复制一份(镜像)发给新版本,但是新版本返回结果丢弃,不影响用户;只用来观测新版本有没有报错、性能是否正常。 ✅ 用来提前发现 bug,不影响真实用户;一般上线前做影子验证 ❌ 双倍流量压力;数据写操作镜像会产生脏数据,影子流量一般只用于读接口
三、完整标准零停机发布流程(以滚动更新举例)
推送镜像 / 打包新版本,构建制品
调度平台启动新版本 Pod / 实例,启动服务
服务启动后执行初始化(加载缓存、连接 DB)
Readiness 就绪探针通过 → 向注册中心注册自己为健康
网关 / 负载均衡感知新实例就绪,开始分发流量
等待一段时间,确认新实例流量正常、监控无异常
开始摘除一个旧实例:注册中心标记为不健康,网关停止发流量(等待存量请求处理完成,优雅关闭)
旧实例收到 SIGTERM,进入优雅关闭:停止接收新请求,等待正在处理的请求跑完,超时后强制退出
循环:新增新实例 → 摘除旧实例,直到全部替换
全量完成后持续观察监控;异常触发回滚:重新发布旧版本镜像
👉 优雅关闭(Graceful Shutdown)是零停机容易踩坑点 Java/SpringBoot 要配置:
关闭时先从注册中心下线(deregister),再停止 web 容器
等待现有请求处理完毕,设置 shutdown 等待超时 如果直接 kill,会造成正在处理的请求中断,用户报错
四、服务间调用如何配合零停机
微服务之间是 RPC/Feign/Dubbo 调用,不是只有网关一层:
客户端负载均衡(Ribbon、Spring Cloud LoadBalancer):会从注册中心实时拉取实例列表,自动过滤不健康实例
熔断降级:Sentinel、Resilience4j,新版本实例短时异常不会雪崩
重试机制:对幂等接口合理重试,规避切换瞬间短暂抖动
消息队列场景:消费者更新也要优雅消费;不要直接停消费者,避免消息丢失;必要时先停止投递、消费完存量再下线
五、数据库层面的零停机(最容易翻车)
服务可以滚动,但 DB schema 变更很容易打破零停机: 原则:数据库变更必须兼容新旧代码同时读写 标准三阶段 DDL:
阶段 1:先执行 DDL(新增字段、索引,允许 NULL,不删不改),此时旧代码完全不受影响
阶段 2:发布新版本代码,读写新字段;新旧版本共存运行一段时间
阶段 3:确认旧版本全部下线后,再执行 DDL 清理(删除废弃字段、加非空约束)
禁止:直接删字段、改字段类型、加非空约束,新旧并存时会直接报错。 大表 DDL 要用 Online DDL(pt-online-schema-change、gh-ost)避免锁表。
六、方案对比总结
七、常见坑
忘记就绪探针:实例还没初始化完就接入流量,大量报错
没有优雅关闭:旧实例直接强杀,正在处理请求失败
版本不兼容 + 滚动发布:新旧同时在线,部分请求异常
本地状态:服务有本地缓存、本地会话,滚动替换后状态丢失(必须无状态)
长连接服务(WebSocket、MQTT):TCP 长连接不会自动断开,滚动更新时会断连,需要客户端重连、连接池处理
监控缺失:发布时没有监控错误率、P99 耗时,出问题不能及时发现
补充:如果不用 K8s,传统虚拟机 / ECS 怎么实现?
思路一样:注册中心 + 健康检查 + 分批部署 + 优雅关闭。 脚本分批升级:一台一台部署新版本,等健康检查 OK 再下一台旧机器;配合 SLB(阿里云 SLB、AWS ELB)的健康检查摘除后端。
本文原创作者:易君召,详见:https://www.yijunzhao.cn/authors/yijunzhao,转载请注明出处。
原文链接
欢迎访问 小易撩挨踢